---
# Só mude aqui!!!!
author: "Marco Antônio e Matheus Villela"
title: "Relatório 01 - Aula prática 01"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/eait/' target='_blank'>Estatística Aplicada a Inovações Tecnológicas (UFSJ)</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
toc-title: "Sumário" # Define o nome do sumário
toc-location: left # Coloca o sumário no lado esquerdo (opcional)
number-sections: true
theme: bootstrap
#css: styles.css
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
# 📌 Introdução
A utilização de ferramentas computacionais na Engenharia Civil tem ampliado a capacidade de organizar, analisar e interpretar grandes conjuntos de dados experimentais. Nesse contexto, a linguagem R constitui uma ferramenta relevante para computação estatística, manipulação de dados e produção de representações gráficas [@Rcore2026].
Este relatório apresenta a aplicação conjunta da programação em R e da Estatística Descritiva à análise de resultados relacionados ao controle tecnológico do concreto. A fundamentação estatística foi desenvolvida com base nos quatro capítulos iniciais do livro *Estatística & Probabilidade aplicada às Engenharias e Ciências*, de Ben Dêivide de O. Batista [@batista2024epaec]. Os fundamentos de programação utilizados foram estudados a partir do material *R Básico*, integrante da coleção *Estudando o Ambiente R* [@Rbasico2022].
A aplicação prática utiliza o pacote `leem`, desenvolvido como ferramenta de apoio ao estudo de Estatística e Programação no ambiente R [@batista2025leem]. A partir de uma base contendo 30 séries de concreto, são analisados o abatimento do tronco de cone (*slump*) e os resultados de resistência à compressão axial obtidos aos 7 e 14 dias.
O objetivo é demonstrar que a utilização de recursos computacionais não substitui os fundamentos matemáticos e estatísticos, mas permite automatizar cálculos, organizar informações e produzir representações que facilitam a interpretação dos resultados. Dessa forma, busca-se estabelecer uma relação entre programação, Estatística Descritiva e situações práticas da Engenharia Civil.
# 🎯 Objetivo geral
Integrar os conhecimentos de programação em R e Estatística Descritiva para analisar dados relacionados ao controle tecnológico do concreto, utilizando o pacote `leem` para organização, tabulação, representação gráfica e cálculo das principais medidas estatísticas.
## Objetivos específicos
* Apresentar os principais fundamentos da linguagem R estudados no curso *R Básico* [@Rbasico2022];
* revisar os conceitos fundamentais dos quatro primeiros capítulos do livro *Estatística & Probabilidade aplicada às Engenharias e Ciências* [@batista2024epaec];
* organizar uma base de dados proveniente de ensaios de concreto;
* calcular medidas de posição, dispersão e forma;
* utilizar tabelas e gráficos para representar os resultados;
* comparar o comportamento da resistência à compressão aos 7 e 14 dias;
* interpretar os resultados estatísticos sob a perspectiva da Engenharia Civil;
* demonstrar a utilização do pacote `leem` como ferramenta computacional para aplicação dos conceitos estudados [@batista2025leem].
# ⚙️ Metodologia
A metodologia foi estruturada em três etapas principais: capacitação em R, revisão dos fundamentos estatísticos e aplicação prática aos dados de concreto.
## Capacitação em R
Inicialmente, foram estudados os fundamentos da linguagem R por meio do curso *R Básico*, composto por 26 aulas [@Rbasico2022]. Foram abordados conceitos relacionados à sintaxe, semântica, objetos, vetores, estruturas de dados, funções, operadores, estruturas de controle, importação de dados e produção de relatórios.
Esses conhecimentos foram posteriormente empregados na organização e análise da base experimental utilizada neste relatório.
## Revisão dos fundamentos estatísticos
A segunda etapa consistiu na revisão dos quatro capítulos iniciais do livro *Estatística & Probabilidade aplicada às Engenharias e Ciências* [@batista2024epaec].
Foram estudados conceitos relacionados à organização dos dados, distribuição de frequências, medidas de posição, medidas de dispersão e interpretação da variabilidade. Também foram considerados os conceitos de assimetria e curtose, utilizados posteriormente para caracterizar a forma das distribuições analisadas.
## Aplicação aos dados de concreto
A terceira etapa consistiu na análise de dados obtidos em ensaios relacionados ao controle tecnológico do concreto utilizado na execução de estacas de fundação de um empreendimento localizado em **Conselheiro Lafaiete – MG**.
O concreto foi fornecido pela empresa **Real Beton** e os dados foram organizados em 30 séries experimentais. Para cada série foram considerados:
* o abatimento do tronco de cone (*slump*);
* dois resultados de resistência à compressão aos 7 dias;
* dois resultados de resistência à compressão aos 14 dias.
Os dois corpos de prova de cada idade foram utilizados para calcular uma resistência média representativa da respectiva série.
A análise foi realizada no ambiente R utilizando o pacote `leem` [@batista2025leem]. Foram executados procedimentos de organização dos dados, distribuição de frequências, construção de gráficos e cálculo de medidas estatísticas.
# 📚 Fundamentação teórica
## Introdução ao R
### Filosofia, Histórico e Diretrizes Teóricas
O R é um software livre e de código aberto voltado à computação estatística e gráficos, criado por Ross Ihaka e Robert Gentleman. Sua sintaxe deriva da linguagem S e sua semântica de Scheme. Desde 1997, é mantido pelo R Core Team e conta com o repositório CRAN. Por ser aberto, permite a inspeção de seu código. Atualmente, é frequentemente utilizado com o RStudio, que organiza ferramentas de programação, execução, ambiente, gráficos e ajuda em uma interface integrada.
------------------------------------------------------------------------
### Os Três Princípios de John Chambers
A arquitetura de software e a engenharia do R são determinadas por três princípios estruturais definidos por John Chambers:
- **O Princípio do Objeto:** "Tudo o que existe em R é um objeto";
- **O Princípio da Função:** "Tudo o que acontece em R é uma chamada de função";
- **O Princípio da Interface:** "As interfaces para outros programas são parte do R".
------------------------------------------------------------------------
### Aspectos Sintáticos Básicos e Comandos Elementares
A *Sintaxe* determina a forma de escrita legítima do código, ao passo que a *Semântica* determina o comportamento e a interpretação desse código pelo sistema.
- **Comentários:** Qualquer linha ou trecho iniciado pelo caractere cerquilha *(#)* é interpretado como comentário e ignorado pelo interpretador;
- **Nomes Sintáticos:** No R, nomes de objetos podem usar letras, números, pontos e _, mas não podem começar por número ou _, nem por ponto seguido de número. O R diferencia maiúsculas de minúsculas e possui palavras reservadas que não podem ser usadas como nomes. Nomes inválidos podem ser corrigidos com make.names();
- **Atribuição vs. Igualdade:** No R, a atribuição de valores a objetos deve ser feita preferencialmente com <-. Já o = deve ser usado principalmente para definir argumentos dentro de funções;
- **Supressão de Exibição:** O uso da função Invisible() permite ocultar a saída impressa no console ao suprimir a chamada interna automática da função print;
- **Persistência da Sessão:** Ao encerrar o *R*, a gravação do espaço de trabalho gera os arquivos ocultos .RData (armazena os objetos criados no Global Environment) e .Rhistory (armazena os comandos executados);
------------------------------------------------------------------------
### Tipagem Física e Estruturas de Dados Nativas
Internamente, o *R* gerencia os dados por meio de 24 tipos físicos de objetos nativos codificados em *C*, modificáveis apenas pelos mantenedores do sistema. Cada objeto carrega dois atributos intrínsecos imutáveis: comprimento e modo. A tipagem real do baixo nível (em *C*) é acessada com a função typeof(), enquanto a tipagem baseada em S é verificada com mode().
#### Vetores Atômicos e Regras de Coerção
Os **vetores atômicos** são estruturas unidimensionais homogêneas. Subdividem-se fisicamente em:
- **Lógico (logical):** valores *TRUE* e *FALSE*;
- **Inteiro (integer):** especificado explicitamente com o sufixo *L* (ex: 1L, que ocupa menor capacidade de memória);
- **Real (double / numeric):** representações de precisão dupla;
- **Caractere (character):** cadeias de textos delimitadas por aspas.
Se elementos de naturezas distintas são inseridos no mesmo vetor por concatenação com a função c(), ocorre uma coerção implícita automática, respeitando a precedência: character \> numeric \> logical.
O operador de sequência (:) é otimizado fisicamente para armazenar apenas o primeiro e o último valor na memória, consumindo recursos mínimos se comparado à concatenação de grandes sequências via c().
#### Valores Especiais
A linguagem R reserva comportamentos semânticos específicos para dados excepcionais:
- **NA (Not Available):** No R representa um dado ausente ou não disponível. Ele se adapta ao tipo do vetor, ocupa uma posição no vetor e, portanto, afeta seu length();
- **NaN (Not a Number):** Indica indeterminações matemáticas (como 0/0). Sob o ponto de vista físico, é tratado como um tipo real de dupla precisão (double);
- **NULL:** Representa a ausência de objeto (uma estrutura vazia). É o único tipo que não possui modo ou comprimento intrínseco, sendo ignorado na concatenação;
- **Inf / -Inf:** Representam valores que tendem ao infinito positivo ou negativo na reta real.
#### A Regra de Reciclagem
Ao realizar operações entre vetores de tamanhos diferentes, o vetor menor é reciclado até igualar o tamanho do maior. Se os comprimentos não forem múltiplos, o R realiza a operação, mas gera um warning.
#### Atributos como Metadados: Matrizes e Arrays
As estruturas bidimensionais (*matrizes*) e multidimensionais (*arrays*) não existem como objetos físicos nativos na linguagem R; representam vetores atômicos comuns aos quais é adicionado o atributo de dimensão dim (metadado armazenado em formato de lista).
- **Matriz:** Atributo dim de comprimento 2 \[linha, coluna\]. O preenchimento padrão com matrix() ocorre por colunas (byrow = FALSE), podendo ser alterado para linha por linha (byrow = TRUE);
- **Array:** Atributo dim de comprimento igual ou superior a 3 \[linha, coluna, matriz\];
- **Indexação:** Realizada por coordenadas separadas por vírgula dentro de colchetes simples: \[linha, coluna\] para matrizes e \[linha, coluna, matriz\] para arrays. Ocultar um parâmetro extrai a dimensão inteira correspondente (ex: x\[, 1\] para extrair a primeira coluna);
#### Listas
As listas são estruturas heterogêneas e recursivas que podem armazenar diferentes tipos de objetos. Seus elementos são acessados principalmente por [[ ]] ou pelo operador $ quando possuem nomes.
#### Quadros de Dados (Data Frames)
O quadro de dados (data frame) é um objeto pertencente à classe S3 "data.frame", estruturado sob a forma física de uma lista. Impõe a restrição de que todas as suas colunas (variáveis) possuam estritamente o mesmo comprimento (número de observações).
- **Criação e Propriedades:** A partir da versão R 4.0, o argumento padrão *stringsAsFactors* da função data.frame() foi alterado para *FALSE*, evitando a coerção automática de strings em fatores;
- **Metadados:** Diferente das listas comuns, o data frame exige a presença simultânea dos atributos class ("data.frame"), names (nomes das colunas) e row.names (identificação física das linhas);
- **Caminho de Busca:** As funções *attach(dados)* e *detach(dados)* anexam ou removem temporariamente os vetores das colunas diretamente no caminho de busca do R, viabilizando a chamada das variáveis diretamente pelo nome sintático, sem exigir o prefixo acompanhado do \*$* (dados$x).
------------------------------------------------------------------------
### Importação, Exportação e Publicação Dinâmica
A importação e exportação de dados no R seguem o Princípio da Interface. Para evitar erros, os arquivos devem estar em texto com codificação estável, sem anotações extras, com colunas homogêneas e nomes sintáticos, preferencialmente usando _ em vez de ..
- **Importação:** Pode ser feita com scan(), que lê os dados sequencialmente, e com read.table() ou read.csv(), que são usados para carregar dados externos em data frames;
- **Exportação:** No R, write.table() exporta dados para arquivos de texto, writexl::write_xlsx() para Excel (podendo criar várias abas), e xtable() para gerar tabelas em LaTeX;
- **Publicação e Relatórios:** O R Markdown (knitr) e o Quarto permitem criar relatórios automatizados integrando código R e textos, gerando formatos como HTML, PDF e DOCX. O Shiny permite criar painéis e dashboards interativos e dinâmicos.
------------------------------------------------------------------------
### O Paradigma das Funções na Linguagem R
Na tipagem *C*, verificável com a função typeof(), as funções dividem-se em três modalidades estruturais:
- **Closure:** Funções escritas de forma legível por usuários utilizando a palavra reservada function;
- **Special:** Funções primitivas internas que não avaliam seus argumentos imediatamente (como os colchetes de indexação \[\] ou chaves {});
- **Built-in:** Funções primitivas internas de baixo nível.
#### Propriedades das Closures
Uma função de usuário possui três componentes essenciais:
- **Formals:** A lista de parâmetros e argumentos formais de entrada. Alguns já possuem valores padrões declarados (como decreasing = *FALSE* na ordenação via sort());
- **Body (Corpo):** O cérebro do algoritmo, delimitado por chaves {} (dispensáveis apenas em corpos de comando compostos por uma única linha);
- **Environment:** O ambiente envolvente no qual a função foi gerada (geralmente o Ambiente Global).
A função *return()* é opcional, pois a função retorna automaticamente o último valor avaliado. Porém, se a última linha for uma atribuição, o resultado não é exibido no console automaticamente.
#### Chamadas de Função e Operador Pipe
O *R* permite executar funções sob três formas de fluxo, sendo:
- **Alinhada:** Funções encadeadas sequencialmente de dentro para fora;
- **Intermediária:** O código é fragmentado e cada etapa parcial é salva sob um nome de objeto temporário;
- **Pipe Nativo (\|\>):** Operador binário que direciona o resultado produzido à sua esquerda diretamente como o primeiro argumento da função declarada à sua direita, resultando em códigos lineares limpos e legíveis.
#### Ambientes de Execução, Escopo Léxico e "Novo Começo"
- **Ambiente de Execução:** É um ambiente temporário gerado de forma blindada no instante em que a função é chamada na memória. Ele retém de forma isolada as associações locais de variáveis da execução.
- **Princípio do Novo Começo:** O *R* inicia toda nova chamada de função a partir de um ambiente de execução inteiramente limpo e zerado, não memorizando os estados das ligações de chamadas passadas;
- **Escopo Léxico:** Se um objeto não for encontrado no ambiente da função, o interpretador procura esse objeto nos ambientes externos hierarquicamente, até encontrá-lo ou retornar um erro.
------------------------------------------------------------------------
### Estruturas de Controle e Otimização de Loops
A lentidão do R em loops geralmente não é culpa da linguagem, mas da falta de pré-alocação de memória e do excesso de cópias de objetos. A melhor solução é evitar loops usando vetorização ou a família apply.
As estruturas nativas de controle de fluxo dividem-se em:
- **if e else:** Estrutura condicional clássica de tamanho unitário (não vetorizada);
- **ifelse (Vetorizado):** Realiza comparações lógicas elemento a elemento entre vetores.
- **switch:** Alternativa limpa que mapeia o fluxo a caminhos específicos sem necessidade de múltiplos blocos if/else encadeados na memóri;
- **repeat:** Repetição contínua de blocos sem critério de parada explícito na declaração. Exige o uso obrigatório de um contador e do comando break interno;
- **while:** Loop com critério de parada explícito indicado em parênteses na sua declaração;
- **for:** Estrutura de iteração sofisticada em que o contador, os passos e o critério de parada automática já vêm integrados em sua própria declaração de condição de loop.
-------------------------------------------------------------------------------------
### Gestão de Memória, Ambientes e o Caminho de Busca (Search Path)
Os ambientes (environments) constituem estruturas de dados de tipo físico environment encarregadas de armazenar as ligações diretas existentes entre nomes e objetos.
Diferenciam-se das listas por quatro aspectos fundamentais:
- **Chaves exclusivas:** Não admitem nomes duplicados dentro do mesmo ambiente;
- **Ausência de ordenação:** Elementos não possuem posições fixas, inviabilizando qualquer tipo de indexação numérica posicional. O acesso deve ocorrer estritamente por nomes de chaves utilizando o cifrão $ ou colchetes duplos;
- **Herança hierárquica:** Todos os ambientes na memória (com exceção estrita do ambiente vazio) apontam para um ambiente pai imediato;
- **Ausência de cópia em modificações:** Os ambientes não sofrem duplicação física na memória do sistema quando sofrem alteração local.
------------------------------------------------------------------------------------
### Interfaces com Outras Linguagens e Inovações Tecnológicas
O *R* contorna limitações de desempenho e interface integrando-se a outras linguagens:
- **Python (reticulate):** Compila e executa scripts Python via source_python();
- **C++ (Rcpp):** Processa algoritmos de alta performance direto na memória do R com sourceCpp();
- **Tcl/Tk (tcltk):** Pacote nativo para criar janelas e menus interativos locais.
--------------------------------------------------------------------------------------
## Revisão sobre a estatística descritiva
### Capítulo 1 - Definições Gerais da Estatística e técnicas de somatórios
A **Estatística** é a ciência responsável por fornecer métodos para coletar, organizar, descrever, analisar e interpretar dados, servindo de base analítica para a tomada de decisões. Divide-se em três grandes ramos:
1. **Estatística Descritiva (Dedutiva):** Conjunto de técnicas voltadas para a coleta, descrição, organização, tabulação e sintetização dos dados;
2. **Probabilidade:** Teoria matemática dedicada a modelar e estudar a incerteza de fenômenos aleatórios;
3. **Estatística Inferencial (Indutiva):** Conjunto de técnicas que permitem extrapolar conclusões obtidas de uma amostra para toda a população correspondente.
#### Método Científico / Estatístico
A pesquisa estatística segue uma sequência estruturada:
::: {.callout-note appearance="simple"}
**Fluxo do Método:** Identificação do Problema
$\rightarrow$ Formulação de Hipóteses $\rightarrow$
Revisão de Literatura $\rightarrow$ Plano Amostral $\rightarrow$ Coleta
e Tratamento de Dados $\rightarrow$ Apresentação $\rightarrow$ Análise
Estatística $\rightarrow$ Conclusão
:::
#### Conceitos Fundamentais
- **População (**$N$): Conjunto de todos os elementos (finito ou
infinito) que compartilham ao menos uma característica comum de interesse;
- **Amostra (**$n$): Subconjunto finito e representativo extraído de uma população;
- **Variável:** Característica de interesse observada nos elementos;
- **Qualitativa:** Atributos não numéricos.
- *Nominal:* Sem ordenação natural (ex: sexo, cor dos olhos);
- *Ordinal:* Existe uma hierarquia/ordem (ex: nível de escolaridade,
classe social);
- **Quantitativa:** Valores numéricos;
- *Discreta:* Resulta de contagens; assume valores inteiros (ex:
número de filhos);
- *Contínua:* Resulta de medições; assume valores reais em um
intervalo (ex: altura, peso).
#### Somatórios ($\sum$)
O símbolo $\sum$ é utilizado para condensar somas extensas:
$$\sum_{i=1}^{n} X_i = X_1 + X_2 + \dots + X_n$$ {#eq-nome}
**Propriedades Algébricas:**
1. **Soma de uma constante:** $$\sum_{i=1}^{n} c = n \cdot c$$ {#eq-nome}
2. **Multiplicação por constante:**
$$\sum_{i=1}^{n} c \cdot X_i = c \sum_{i=1}^{n} X_i$$ {#eq-nome}
3. **Distributiva da soma e subtração:**
$$\sum_{i=1}^{n} (X_i \pm Y_i) = \sum_{i=1}^{n} X_i \pm \sum_{i=1}^{n} Y_i$$ {#eq-nome}
4. **Soma dos desvios em relação à média (Propriedade Fundamental):**
$$\sum_{i=1}^{n} (X_i - \bar{X}) = 0$$ {#eq-nome}
------------------------------------------------------------------------
### Capítulo 2 - Coleta, Organização e Apresentação dos Dados
#### Organização de Dados
- **Dados Brutos:** Coleção de dados em seu estado original, sem
ordenação.
- **Rol:** Arranjo dos dados brutos em ordem crescente ou decrescente.
#### Representação Tabular de Frequências
- **Frequência Absoluta (**$f_i$): Número de ocorrências de cada
valor/categoria $i$.
- **Frequência Relativa (**$f_{ri}$): Proporção em relação ao total de
observações:
$$f_{ri} = \frac{f_i}{n}$$ {#eq-nome}
- **Frequência Percentual (**$f_{\%i}$):
$$f_{\%i} = f_{ri} \times 100$$ {#eq-nome}
- **Frequência Acumulada Abaixo de (**$f_{ac\downarrow}$): Soma
acumulada das frequências da menor categoria até a classe atual.
- **Frequência Acumulada Acima de (**$f_{ac\uparrow}$): Soma acumulada
das frequências da maior categoria até a classe atual.
#### Distribuição em Intervalos de Classe
Recomendado para agrupamento de variáveis quantitativas contínuas:
- **Amplitude Total (**$A_t$): $$A_t = X_{\text{máx}} - X_{\text{mín}}$$ {#eq-nome}
- **Número de Classes (**$k$): Determinado por regra prática ou pela
**Regra de Sturges**: $$k \approx 1 + 3{,}322 \cdot \log_{10}(n)$$ {#eq-nome}
- **Amplitude do Intervalo de Classe (**$c$):
$$c \approx \frac{A_t}{k}$$ {#eq-nome}
- **Ponto Médio da Classe (**$\tilde{X}_i$): Representante de todas as
observações contidas na classe $i$:
$$\tilde{X}_i = \frac{L_{inf} + L_{sup}}{2}$$ {#eq-nome}
#### Representação Gráfica
| Tipo de Variável | Gráficos Indicados |
|:-----------------------------------|:-----------------------------------|
| **Qualitativa / Discreta** | Barras, Colunas, Setores (Pizza) |
| **Quantitativa Contínua (Classes)** | Histograma, Polígono de Frequências |
| **Frequências Acumuladas** | Ogiva Crescente / Decrescente |
::: callout-tip
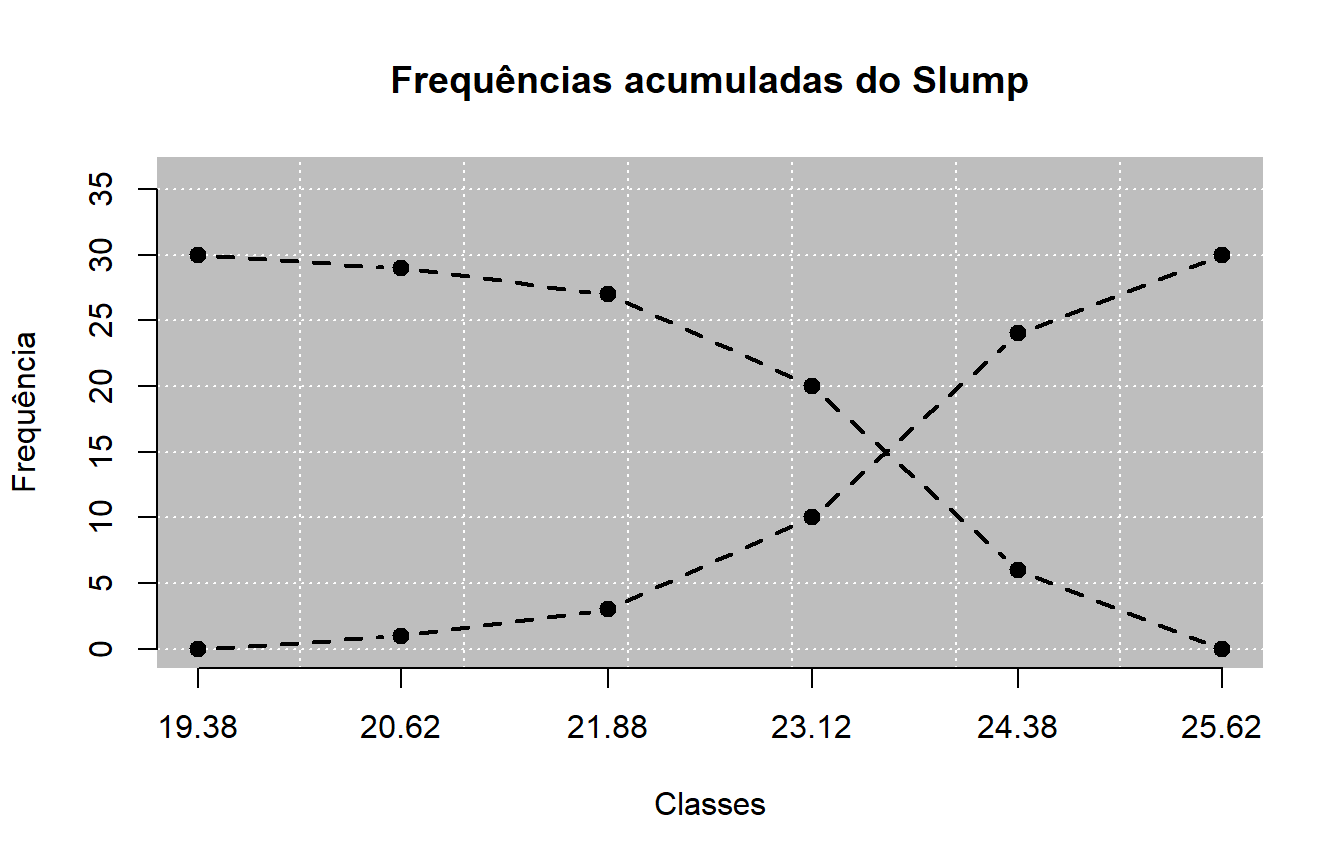
**Interseção das Ogivas:** O ponto em que a ogiva acumulada crescente se
cruza com a ogiva acumulada decrescente fornece graficamente o valor
exato da **Mediana (**$Md$).
:::
------------------------------------------------------------------------
### Capítulo 3 - Medidas de Posição (Tendência Central)
Sintetizam o conjunto de dados em um valor central de referência.
#### Média Aritmética ($\bar{X}$ para amostra, $\mu$ para população)
Representa o ponto de equilíbrio dos dados. É única e aplicável a
variáveis quantitativas, porém altamente sensível a valores extremos
(*outliers*).
- **Dados Não Agrupados:** $$\bar{X} = \frac{\sum_{i=1}^{n} X_i}{n}$$ {#eq-nome}
- **Dados Agrupados com Frequências:**
$$\bar{X} = \frac{\sum_{i=1}^{k} f_i \cdot X_i}{n}$$ {#eq-nome}
- **Dados Agrupados em Classes:**
$$\bar{X} = \frac{\sum_{i=1}^{k} f_i \cdot \tilde{X}_i}{n}$$ {#eq-nome}
- **Média Aparada:** Descarta simetricamente uma porcentagem dos menores
e maiores valores para amenizar o impacto de *outliers*.
#### Mediana ($Md$ ou $\mu_d$)
Valor ordenado central que divide a distribuição em duas partes iguais
($50\%$ abaixo e $50\%$ acima). Trata-se de uma medida **robusta** a
valores discrepantes.
- **Dados Não Agrupados:**
1. Ordene os dados em Rol.
2. Se $n$ for **ímpar**, a posição é $P = \frac{n + 1}{2}$ {#eq-nome}:
$$Md = X_{(P)}$$ {#eq-nome}
3. Se $n$ for **par**, calcula-se a média dos dois elementos
centrais: $$Md = \frac{X_{(n/2)} + X_{(n/2 + 1)}}{2}$$ {#eq-nome}
- **Dados Agrupados em Classes (Interpolação Linear):**
$$Md = L_i + \left[ \frac{\frac{n}{2} - F_{ac\_ant}}{f_{md}} \right] \cdot c$$ {#eq-nome}
*Onde:* $L_i$ é o limite inferior da classe mediana, $F_{ac\_ant}$ é a
frequência acumulada anterior, $f_{md}$ é a frequência absoluta da
classe mediana e $c$ é a amplitude da classe.
#### Moda ($Mo$ ou $\mu_o$)
Valor de ocorrência mais frequente no conjunto de dados.
- **Classificação:**
- **Amodal:** Sem repetição de dados.
- **Unimodal / Bimodal / Multimodal:** Apresenta 1, 2 ou mais modas.
- **Relação Empírica de Pearson:**
$$Mo = 3 \cdot Md - 2 \cdot \bar{X}$$ {#eq-nome}
- **Moda de Czuber (para dados agrupados em classes):**
$$Mo = L_i + \left[ \frac{\Delta_1}{\Delta_1 + \Delta_2} \right] \cdot c$$ {#eq-nome}
*Onde:*
$$\Delta_1 = f_{mo} - f_{ant}$$ {#eq-nome}
e
$$\Delta_2 = f_{mo} - f_{post}$$ {#eq-nome} .
------------------------------------------------------------------------
### Capítulo 4 - Medidas de Dispersão (Variabilidade)
Caracterizam a variação e o afastamento das observações em relação à
média aritmética.
#### Amplitude Total ($A_t$)
Diferença entre o maior e o menor valor observado:
$$A_t = X_{\text{máx}} - X_{\text{mín}}$$ {#eq-nome}
#### Variância ($S^2$ ou $\sigma^2$)
Média dos desvios quadráticos das observações em relação à média.
- **Variância Populacional (**$\sigma^2$):
$$\sigma^2 = \frac{\sum_{i=1}^{N} (X_i - \mu)^2}{N}$$ {#eq-nome}
- **Variância Amostral (**$S^2$): Utiliza o denominador $n-1$ (graus de
liberdade) para corrigir o viés estatístico do estimador:
$$S^2 = \frac{\sum_{i=1}^{n} (X_i - \bar{X})^2}{n - 1}$$ {#eq-nome}
- **Fórmula Prática Computacional (Amostral):**
$$S^2 = \frac{\sum X_i^2 - \frac{(\sum X_i)^2}{n}}{n - 1}$$ {#eq-nome}
#### Desvio Padrão ($S$ ou $\sigma$)
Raiz quadrada positiva da variância, retornando a variabilidade para a
mesma unidade original da variável:
$$S = \sqrt{S^2} \quad \text{ou} \quad \sigma = \sqrt{\sigma^2}$$ {#eq-nome}
#### Coeficiente de Variação ($CV$)
Medida adimensional de dispersão relativa expressa em percentual, permitindo a comparação de variabilidade entre grupos com escalas ou médias distintas:
$$CV = \left( \frac{S}{\bar{X}} \right) \times 100\%$$ {#eq-nome}
#### Erro Padrão da Média ($S_{\bar{X}}$ ou $\sigma_{\bar{X}}$)
Mede a precisão e a variabilidade das possíveis médias amostrais em relação à média populacional:
$$S_{\bar{X}} = \frac{S}{\sqrt{n}}$$ {#eq-nome}
------------------------------------------------------------------------
### Assimetria (Skewness)
A Assimetria descreve o desvio de simetria de uma curva de distribuição de frequências em relação ao seu centro (média).
#### Classificação da Assimetria
- **Simétrica:** Ocorre quando a média, a mediana e a moda coincidem.
Os dois lados da distribuição são espelhados.
$$\bar{X} = Md = Mo \implies A_s = 0$$ {#eq-nome}
- **Assimétrica Positiva (à Direita):** Apresenta cauda mais longa à direita, indicando concentração de dados nos valores abaixo da média.
$$Mo < Md < \bar{X} \implies A_s > 0$$ {#eq-nome}
- **Assimétrica Negativa (à Esquerda):** Apresenta cauda mais longa à
esquerda, indicando concentração de dados nos valores acima da média.
$$\bar{X} < Md < Mo \implies A_s < 0$$ {#eq-nome}
#### Fórmulas de Cálculo
- **Primeiro Coeficiente de Pearson:**
$$A_S = \frac{\bar{X} - Mo}{S}$$ {#eq-nome}
- **Segundo Coeficiente de Pearson:**
$$A_S = \frac{3(\bar{X} - Md)}{S}$$ {#eq-nome}
- **Coeficiente de Fisher (**$g_1$): Baseado no terceiro momento central
$m_3 = \frac{1}{n} \sum (X_i - \bar{X})^3$: $$g_1 = \frac{m_3}{S^3}$$ {#eq-nome}
*(O intervalo* $[-1, +1]$ costuma ser considerado como indicador de
uma distribuição aproximadamente simétrica).
------------------------------------------------------------------------
### Curtose (Kurtosis)
A Curtose mede o grau de achatamento ou afunilamento (pico) da curva de
distribuição de frequências em comparação com a Curva Normal padrão de
referência.
#### Classificação da Curtose
- **Mesocúrtica:** Apresenta o mesmo grau de achatamento da distribuição
normal padrão ($g_2 = 0$ ou $K = 3$);
- **Leptocúrtica:** Curva mais estreita e pontiaguda que a normal
($g_2 > 0$ ou $K > 3$), indicando alta concentração de dados ao redor do centro;
- **Platicúrtica:** Curva mais achatada e espalhada que a normal
($g_2 < 0$ ou $K < 3$), indicando dados mais distribuídos de forma homogênea.
#### Fórmulas de Cálculo
- **Coeficiente de Fisher (**$g_2$): Baseado no quarto momento central
$m_4 = \frac{1}{n} \sum (X_i - \bar{X})^4$:
$$g_2 = \frac{m_4}{S^4} - 3$$ {#eq-nome}
# 👷♂️ Aplicação prática
## Caracterização da base de dados
A base de dados contém 30 séries de concreto. Para cada série foram registradas cinco informações experimentais principais, conforme apresentado na @tbl-variaveis.
```{r}
#| label: tbl-variaveis
#| tbl-cap: "Variáveis utilizadas na análise."
tabela_variaveis <- data.frame(
  Variável = c(
    "Slump",
    "CP1 - 7 dias",
    "CP2 - 7 dias",
    "CP3 - 14 dias",
    "CP4 - 14 dias",
    "Resistência média - 7 dias",
    "Resistência média - 14 dias"
  ),
  Unidade = c(
    "cm",
    "MPa",
    "MPa",
    "MPa",
    "MPa",
    "MPa",
    "MPa"
  ),
  Observações = rep(30, 7),
  Descrição = c(
    "Abatimento do tronco de cone",
    "Resistência à compressão",
    "Resistência à compressão",
    "Resistência à compressão",
    "Resistência à compressão",
    "Média dos CP1 e CP2",
    "Média dos CP3 e CP4"
  )
)

knitr::kable(
  tabela_variaveis,
  align = c("l", "c", "c", "l")
) |>
  kableExtra::kable_styling(
    bootstrap_options = c(
      "striped",
      "hover",
      "condensed",
      "responsive"
    ),
    full_width = FALSE
  )
```
## Importação e preparação dos dados
A base de dados foi armazenada em formato `.CSV` e importada para o ambiente R.
```{r}
library(leem)
library(kableExtra)

dados <- read.csv(
  "Analise_de_Concreto.CSV",
  header = TRUE,
  sep = ";",
  dec = ","
)

head(dados)
```
As resistências médias foram calculadas para cada série:
```{r}
dados$Resistencia_7d <- rowMeans(
  dados[, c("CP1_7d", "CP2_7d")],
  na.rm = TRUE
)

dados$Resistencia_14d <- rowMeans(
  dados[, c("CP3_14d", "CP4_14d")],
  na.rm = TRUE
)
```
A utilização da média dos dois corpos de prova permite representar cada série por um único valor de resistência para cada idade.
```{r}
dados[
  ,
  c(
    "Series",
    "Slump_cm",
    "Resistencia_7d",
    "Resistencia_14d"
  )
]
```
## Funções auxiliares para a análise
Para evitar repetição de código, foram criadas funções para calcular as principais medidas estatísticas.
```{r}
assimetria_fisher <- function(x) {
  media <- mean(x, na.rm = TRUE)
  dp <- sd(x, na.rm = TRUE)

  mean(
    (x - media)^3,
    na.rm = TRUE
  ) / dp^3
}

curtose_pearson <- function(x) {
  media <- mean(x, na.rm = TRUE)
  dp <- sd(x, na.rm = TRUE)

  mean(
    (x - media)^4,
    na.rm = TRUE
  ) / dp^4
}

resumo_estatistico <- function(x) {

  media <- mean(x, na.rm = TRUE)
  dp <- sd(x, na.rm = TRUE)

  data.frame(
    Média = media,
    Mediana = median(x, na.rm = TRUE),
    Moda = {
      tab <- table(x)
      as.numeric(names(tab)[which.max(tab)])
    },
    Variância = var(x, na.rm = TRUE),
    Desvio_Padrão = dp,
    Amplitude = max(x, na.rm = TRUE) -
      min(x, na.rm = TRUE),
    CV = dp / media * 100,
    Erro_Padrão = dp /
      sqrt(sum(!is.na(x))),
    Assimetria = assimetria_fisher(x),
    Curtose = curtose_pearson(x),
    Excesso_Curtose =
      curtose_pearson(x) - 3
  )
}
```
---
## Análise do slump
### Organização dos dados
O rol corresponde aos valores organizados em ordem crescente. No presente estudo, ele é apresentado para o *slump* como exemplo de aplicação do conceito.
```{r}
rol_slump <- sort(dados$Slump_cm)

rol_slump
```
A ordenação permite identificar os menores e maiores valores observados e constitui uma etapa inicial para análise da distribuição.
### Distribuição de frequência
A distribuição de frequência foi obtida utilizando o pacote `leem` [@batista2025leem].
```{r}
freq_slump <- dados$Slump_cm |>
  new_leem(variable = "continuous") |>
  tabfreq()

freq_slump
```
A tabela permite visualizar as classes de abatimento e suas respectivas frequências absolutas, relativas e acumuladas.
### Histograma
```{r}
#| label: fig-hist-slump
#| fig-cap: "Distribuição dos valores de slump das 30 séries analisadas."
#| fig-width: 7
#| fig-height: 4.5
dados$Slump_cm |>
  new_leem(variable = "continuous") |>
  tabfreq() |>
  hist(
    main = "Distribuição do Slump",
    xlab = "Slump (cm)",
    ylab = "Frequência"
  )
```
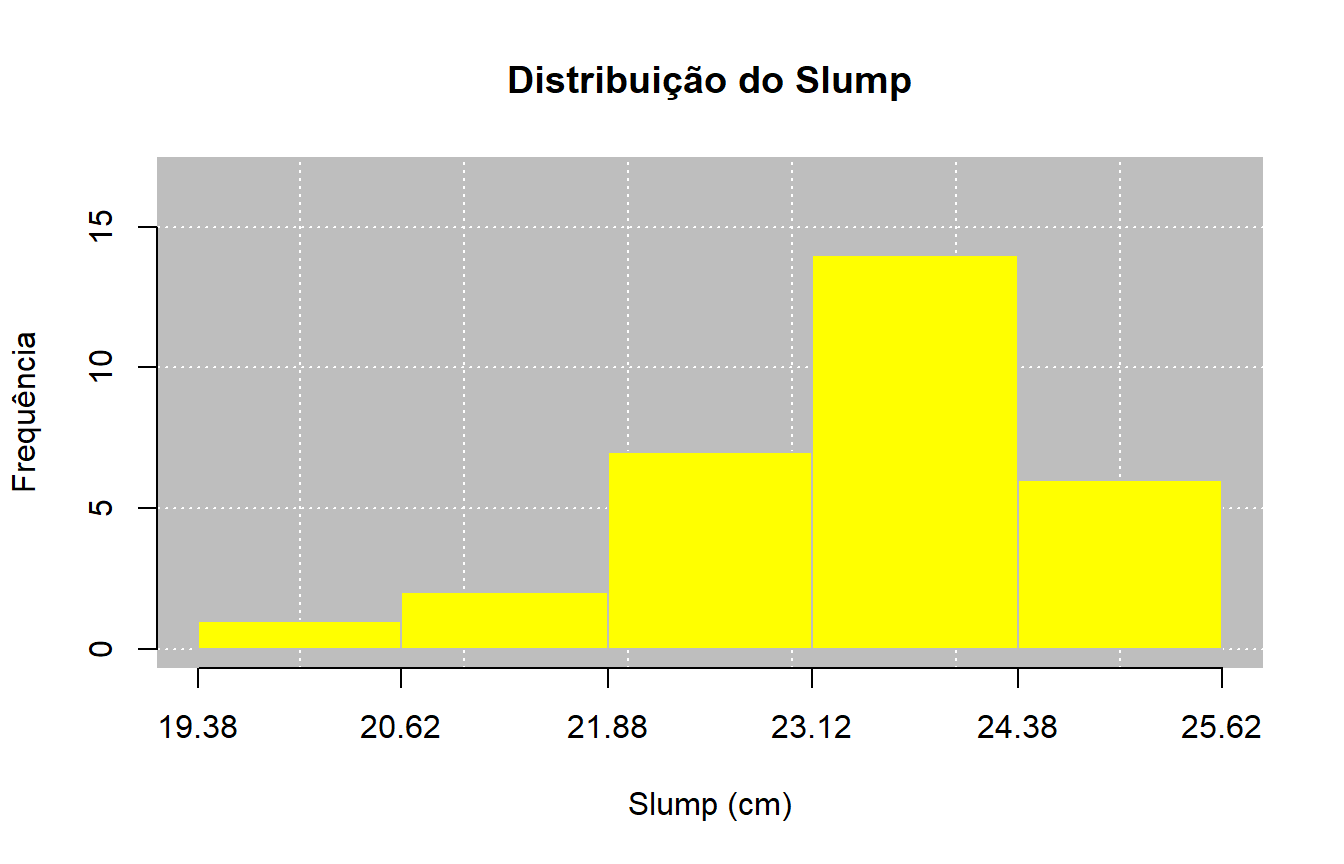
A distribuição dos resultados de *slump* pode ser observada na @fig-hist-slump. O gráfico permite identificar a região de maior concentração dos valores e possíveis afastamentos em relação ao centro da distribuição.
### Ogiva
```{r}
#| label: fig-ogiva-slump
#| fig-cap: "Frequências acumuladas do slump."
#| fig-width: 7
#| fig-height: 4.5
dados$Slump_cm |>
  new_leem(variable = "continuous") |>
  tabfreq() |>
  ogive(
    both = TRUE,
    main = "Frequências acumuladas do Slump"
  )
```
As frequências acumuladas permitem avaliar a proporção de resultados abaixo ou acima de determinados intervalos de abatimento.
### Medidas descritivas
```{r}
estat_slump <- resumo_estatistico(
  dados$Slump_cm
)

tabela_slump <- data.frame(
  Medida = c(
    "Média",
    "Mediana",
    "Moda",
    "Variância",
    "Desvio-padrão",
    "Amplitude",
    "Coeficiente de variação",
    "Erro-padrão",
    "Assimetria",
    "Curtose",
    "Excesso de curtose"
  ),
  Resultado = c(
    estat_slump$Média,
    estat_slump$Mediana,
    estat_slump$Moda,
    estat_slump$Variância,
    estat_slump$Desvio_Padrão,
    estat_slump$Amplitude,
    estat_slump$CV,
    estat_slump$Erro_Padrão,
    estat_slump$Assimetria,
    estat_slump$Curtose,
    estat_slump$Excesso_Curtose
  )
)

knitr::kable(
  tabela_slump,
  digits = 3,
  col.names = c(
    "Medida",
    "Resultado"
  ),
  caption = "Estatísticas descritivas do slump."
) |>
  kableExtra::kable_styling(
    bootstrap_options = c(
      "striped",
      "hover",
      "condensed",
      "responsive"
    ),
    full_width = FALSE
  )
```
A média do *slump* é de aproximadamente **23,45 cm**, enquanto a mediana é de aproximadamente **24,00 cm**. A proximidade entre essas duas medidas indica concentração dos resultados em uma região próxima a 24 cm.
O desvio-padrão é de aproximadamente **1,23 cm** e o coeficiente de variação é de aproximadamente **5,23%**, indicando baixa variabilidade relativa entre as séries.
A assimetria negativa indica maior alongamento da distribuição em direção aos menores valores de abatimento. A curtose de aproximadamente 3,36 corresponde a um excesso de curtose positivo, indicando comportamento mais concentrado em torno do centro e/ou maior peso das caudas em relação à distribuição normal, segundo a definição adotada.
Do ponto de vista do controle tecnológico, a baixa variabilidade relativa do *slump* indica que os abatimentos observados nas diferentes séries apresentam comportamento relativamente uniforme. Entretanto, a avaliação da adequação do abatimento deve considerar também o traço, a classe de consistência especificada, o elemento estrutural e as condições de lançamento do concreto.
---
## Análise da resistência aos 7 dias
### Distribuição de frequência
```{r}
freq_7d <- dados$Resistencia_7d |>
  new_leem(variable = "continuous") |>
  tabfreq()

freq_7d
```
### Histograma
```{r}
#| label: fig-hist-7d
#| fig-cap: "Distribuição da resistência média do concreto aos 7 dias."
#| fig-width: 7
#| fig-height: 4.5
dados$Resistencia_7d |>
  new_leem(variable = "continuous") |>
  tabfreq() |>
  hist(
    main = "Resistência à compressão — 7 dias",
    xlab = "Resistência (MPa)",
    ylab = "Frequência"
  )
```
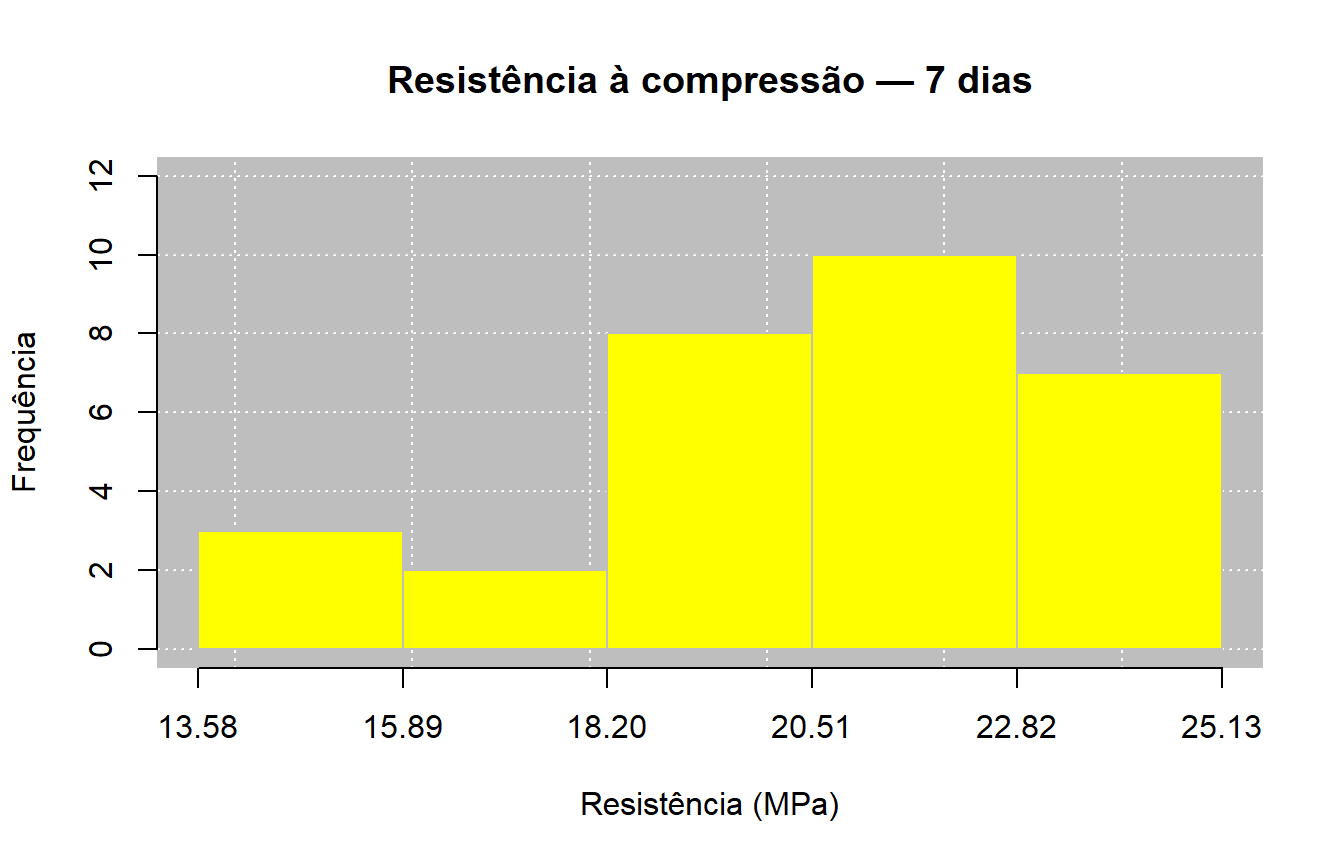
A @fig-hist-7d apresenta a distribuição das resistências médias obtidas aos 7 dias.
### Medidas descritivas
```{r}
estat_7d <- resumo_estatistico(
  dados$Resistencia_7d
)

tabela_7d <- data.frame(
  Medida = c(
    "Média",
    "Mediana",
    "Moda",
    "Variância",
    "Desvio-padrão",
    "Amplitude",
    "Coeficiente de variação",
    "Erro-padrão",
    "Assimetria",
    "Curtose",
    "Excesso de curtose"
  ),
  Resultado = c(
    estat_7d$Média,
    estat_7d$Mediana,
    estat_7d$Moda,
    estat_7d$Variância,
    estat_7d$Desvio_Padrão,
    estat_7d$Amplitude,
    estat_7d$CV,
    estat_7d$Erro_Padrão,
    estat_7d$Assimetria,
    estat_7d$Curtose,
    estat_7d$Excesso_Curtose
  )
)

knitr::kable(
  tabela_7d,
  digits = 3,
  col.names = c(
    "Medida",
    "Resultado"
  ),
  caption = "Estatísticas descritivas da resistência aos 7 dias."
) |>
  kableExtra::kable_styling(
    bootstrap_options = c(
      "striped",
      "hover",
      "condensed",
      "responsive"
    ),
    full_width = FALSE
  )
```
A resistência média aos 7 dias é de aproximadamente **20,69 MPa**, com desvio-padrão de aproximadamente **2,95 MPa**.
O coeficiente de variação, de aproximadamente **14,25%**, demonstra uma dispersão relativa superior à observada para o *slump*. Isso significa que as séries apresentam maior heterogeneidade quanto à resistência aos 7 dias.
Essa variabilidade pode estar relacionada a diferentes fatores presentes no processo tecnológico do concreto, como produção, transporte, moldagem dos corpos de prova, cura e realização dos ensaios. Entretanto, os resultados descritivos não permitem identificar isoladamente a causa da variabilidade.
---
## Análise da resistência aos 14 dias
### Distribuição de frequência
```{r}
freq_14d <- dados$Resistencia_14d |>
  new_leem(variable = "continuous") |>
  tabfreq()

freq_14d
```
### Histograma
```{r}
#| label: fig-hist-14d
#| fig-cap: "Distribuição da resistência média do concreto aos 14 dias."
#| fig-width: 7
#| fig-height: 4.5
dados$Resistencia_14d |>
  new_leem(variable = "continuous") |>
  tabfreq() |>
  hist(
    main = "Resistência à compressão — 14 dias",
    xlab = "Resistência (MPa)",
    ylab = "Frequência"
  )
```
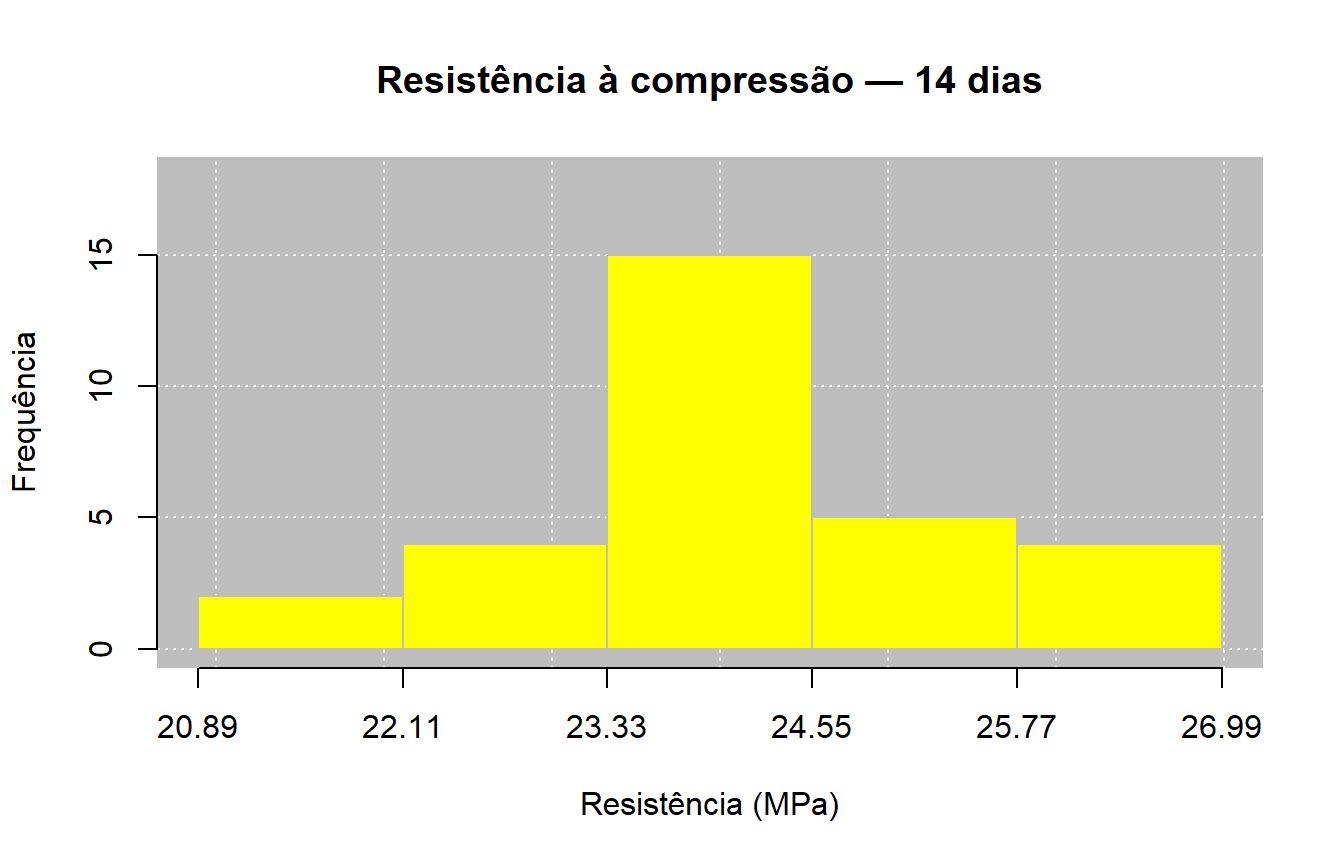
A @fig-hist-14d apresenta a distribuição das resistências médias aos 14 dias.
### Medidas descritivas
```{r}
estat_14d <- resumo_estatistico(
  dados$Resistencia_14d
)

tabela_14d <- data.frame(
  Medida = c(
    "Média",
    "Mediana",
    "Moda",
    "Variância",
    "Desvio-padrão",
    "Amplitude",
    "Coeficiente de variação",
    "Erro-padrão",
    "Assimetria",
    "Curtose",
    "Excesso de curtose"
  ),
  Resultado = c(
    estat_14d$Média,
    estat_14d$Mediana,
    estat_14d$Moda,
    estat_14d$Variância,
    estat_14d$Desvio_Padrão,
    estat_14d$Amplitude,
    estat_14d$CV,
    estat_14d$Erro_Padrão,
    estat_14d$Assimetria,
    estat_14d$Curtose,
    estat_14d$Excesso_Curtose
  )
)

knitr::kable(
  tabela_14d,
  digits = 3,
  col.names = c(
    "Medida",
    "Resultado"
  ),
  caption = "Estatísticas descritivas da resistência aos 14 dias."
) |>
  kableExtra::kable_styling(
    bootstrap_options = c(
      "striped",
      "hover",
      "condensed",
      "responsive"
    ),
    full_width = FALSE
  )
```
A resistência média aos 14 dias é de aproximadamente **24,14 MPa**, com desvio-padrão de aproximadamente **1,32 MPa**.
O coeficiente de variação é de aproximadamente **5,46%**, valor consideravelmente inferior ao observado aos 7 dias.
Portanto, além do aumento da resistência média, observa-se uma redução da dispersão relativa entre as séries. Isso demonstra a importância de analisar conjuntamente medidas de posição e dispersão, pois o aumento da média, isoladamente, não seria suficiente para caracterizar o comportamento dos resultados.
---
## Comparação entre 7 e 14 dias
A comparação entre as duas idades constitui uma das principais análises deste estudo.
```{r}
comparacao_idades <- data.frame(
  Indicador = c(
    "Média",
    "Mediana",
    "Desvio-padrão",
    "Coeficiente de variação (%)"
  ),

  `7 dias` = c(
    estat_7d$Média,
    estat_7d$Mediana,
    estat_7d$Desvio_Padrão,
    estat_7d$CV
  ),

  `14 dias` = c(
    estat_14d$Média,
    estat_14d$Mediana,
    estat_14d$Desvio_Padrão,
    estat_14d$CV
  )
)

knitr::kable(
  comparacao_idades,
  digits = 3,
  col.names = c(
    "Indicador",
    "7 dias",
    "14 dias"
  ),
  caption = "Comparação das estatísticas descritivas entre 7 e 14 dias."
) |>
  kableExtra::kable_styling(
    bootstrap_options = c(
      "striped",
      "hover",
      "condensed",
      "responsive"
    ),
    full_width = FALSE
  )
```
O aumento relativo da resistência média foi calculado por:
$$
G=
\frac{
\bar{X}*{14}-\bar{X}*{7}
}{
\bar{X}_{7}
}
\times100
$$ {#eq-ganho-resistencia}
```{r}
ganho_medio <- (
  (
    mean(dados$Resistencia_14d) -
      mean(dados$Resistencia_7d)
  ) /
    mean(dados$Resistencia_7d)
) * 100

ganho_medio
```
O aumento médio calculado é de aproximadamente **16,7%**.
Esse resultado demonstra que a resistência média observada aos 14 dias é superior àquela registrada aos 7 dias. Esse comportamento é compatível com o processo de desenvolvimento da resistência do concreto ao longo da idade.
Entretanto, é importante destacar que esta análise possui caráter **descritivo**. Portanto, o aumento observado não deve ser interpretado como uma estimativa universal do ganho de resistência do concreto entre essas idades, nem como uma relação causal isolada.
---
## Comparação gráfica das resistências
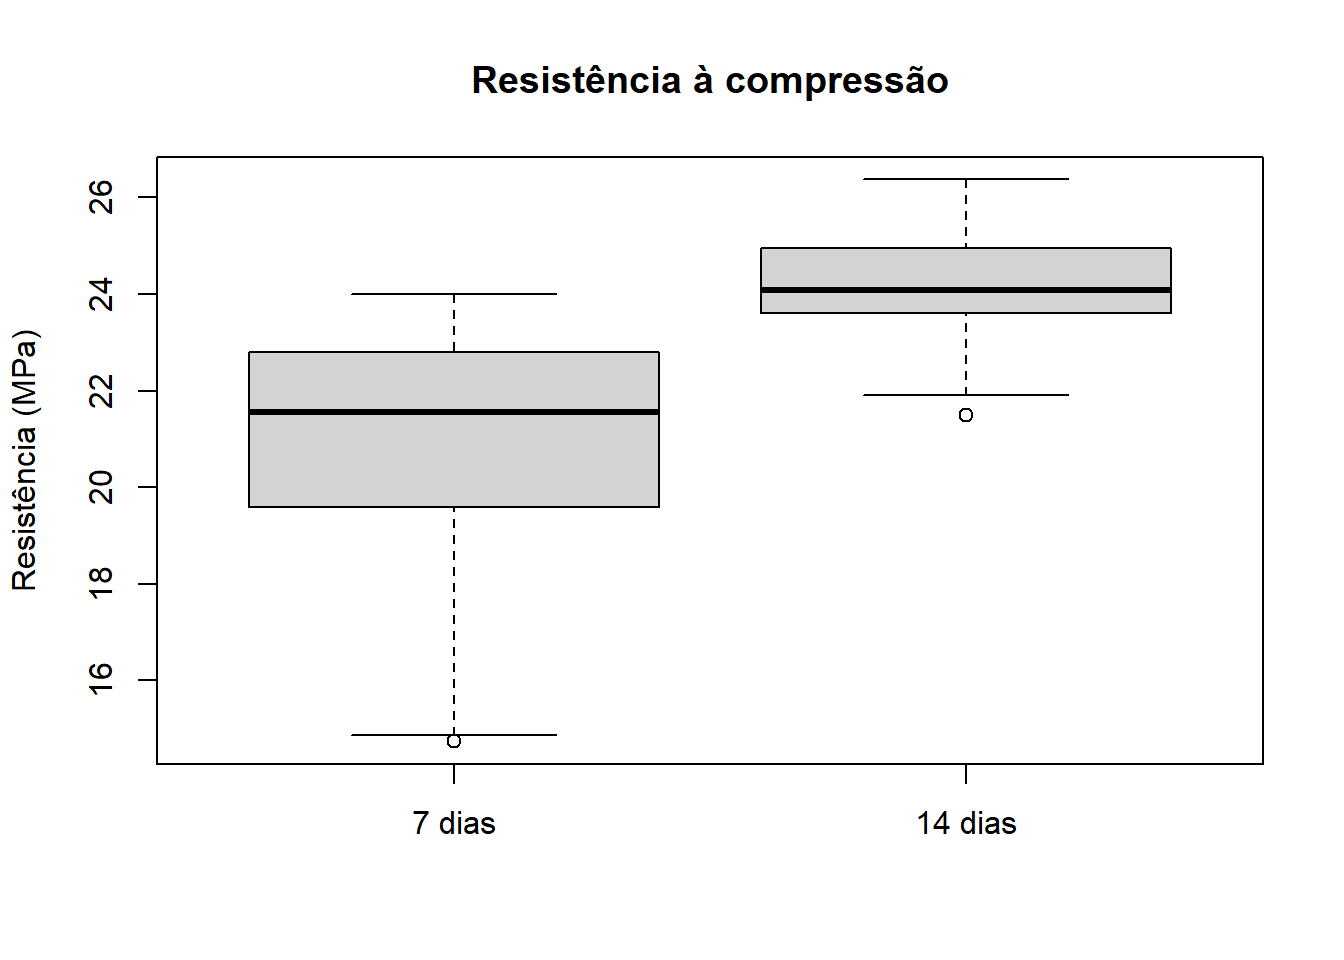
O box-plot permite comparar simultaneamente a posição central, dispersão e possíveis valores discrepantes das duas distribuições.
```{r}
#| label: fig-boxplot-idades
#| fig-cap: "Comparação da distribuição das resistências médias aos 7 e 14 dias."
#| fig-width: 7
#| fig-height: 5
boxplot(
  dados$Resistencia_7d,
  dados$Resistencia_14d,
  names = c(
    "7 dias",
    "14 dias"
  ),
  main = "Resistência à compressão",
  ylab = "Resistência (MPa)"
)
```
A @fig-boxplot-idades evidencia o deslocamento da distribuição para valores superiores aos 14 dias. Também é possível observar a redução da dispersão dos resultados nessa idade.
Esse comportamento é consistente com os valores obtidos para o coeficiente de variação: aproximadamente 14,25% aos 7 dias e 5,46% aos 14 dias.
---
# 🔍 Resultados e Discussão
Os principais indicadores estatísticos obtidos na análise são apresentados na tabela a seguir:
```{r}
resumo_geral <- data.frame(

  Variável = c(
    "Slump (cm)",
    "Resistência 7 dias (MPa)",
    "Resistência 14 dias (MPa)"
  ),

  Média = c(
    estat_slump$Média,
    estat_7d$Média,
    estat_14d$Média
  ),

  Mediana = c(
    estat_slump$Mediana,
    estat_7d$Mediana,
    estat_14d$Mediana
  ),

  Desvio_Padrão = c(
    estat_slump$Desvio_Padrão,
    estat_7d$Desvio_Padrão,
    estat_14d$Desvio_Padrão
  ),

  CV_percentual = c(
    estat_slump$CV,
    estat_7d$CV,
    estat_14d$CV
  ),

  Assimetria = c(
    estat_slump$Assimetria,
    estat_7d$Assimetria,
    estat_14d$Assimetria
  ),

  Curtose = c(
    estat_slump$Curtose,
    estat_7d$Curtose,
    estat_14d$Curtose
  )
)

knitr::kable(
  resumo_geral,
  digits = 3,
  col.names = c(
    "Variável",
    "Média",
    "Mediana",
    "Desvio-padrão",
    "CV (%)",
    "Assimetria",
    "Curtose"
  ),
  caption = "Síntese das principais estatísticas descritivas."
) |>
  kableExtra::kable_styling(
    bootstrap_options = c(
      "striped",
      "hover",
      "condensed",
      "responsive"
    ),
    full_width = TRUE
  )
```
## Análise dos Resultados
A análise estatística descritiva das 30 séries experimentais de concreto revelou padrões distintos de comportamento entre o estado fresco (*slump*) e o estado endurecido, representado pela resistência mecânica aos 7 e 14 dias.
### Consistência do Concreto Fresco (*Slump Test*)
- **Tendência central e posição:** O *slump* apresentou **média de 23,45 cm**, enquanto a **mediana** e a **moda** foram de **24,00 cm**. A proximidade entre essas medidas de posição indica uma concentração dos dados em torno de um patamar relativamente uniforme de trabalhabilidade.
- **Dispersão:** O **desvio-padrão de 1,23 cm** e o **Coeficiente de Variação (CV) de 5,23%** evidenciam uma **baixa variabilidade relativa** dos resultados. Esse comportamento indica que os valores de abatimento apresentaram pequena dispersão em relação à média, sugerindo boa uniformidade entre as séries analisadas.
- **Forma:** A distribuição apresentou **assimetria negativa**, com $g_1 = -1,03$, indicando a presença de uma cauda mais alongada em direção aos menores valores de abatimento. A **curtose de 3,36**, considerando o coeficiente de curtose sem excesso, caracteriza a distribuição como **leptocúrtica**, indicando maior concentração das observações em torno de sua região central.
### Resistência Mecânica à Compressão aos 7 Dias
- **Tendência central e dispersão:** A resistência aos 7 dias apresentou **média de 20,69 MPa**, **mediana de 21,55 MPa** e **desvio-padrão de 2,71 MPa**. O **Coeficiente de Variação de 13,08%** evidencia uma dispersão relativa superior à observada para o *slump*.
- **Interpretação:** A maior dispersão dos resultados de resistência aos 7 dias demonstra que uma maior uniformidade do concreto no estado fresco não implica, necessariamente, a mesma uniformidade na resistência mecânica inicial. A resistência pode apresentar variações associadas a diferentes fatores relacionados à produção, moldagem, cura e às próprias características do material.
- **Forma:** A distribuição apresentou **assimetria negativa moderada**, com $g_1 = -0,81$, indicando maior concentração das observações nos valores superiores da distribuição e uma cauda relativamente mais alongada para os menores valores. A **curtose de 2,59** caracteriza a distribuição como **platicúrtica**, segundo a classificação adotada neste trabalho.
### Resistência Mecânica à Compressão aos 14 Dias
- **Tendência central e evolução:** A **resistência média elevou-se para 24,14 MPa**, enquanto a mediana foi de **24,08 MPa**. Em comparação aos resultados aos 7 dias, isso representa um **ganho médio de resistência de aproximadamente 16,7%**, comportamento compatível com a evolução da resistência do concreto ao longo da idade.
- **Dispersão e estabilização:** O **desvio-padrão reduziu-se para 1,26 MPa**, enquanto o **Coeficiente de Variação passou para 5,22%**. A redução da dispersão relativa indica maior uniformidade dos resultados aos 14 dias em comparação com a idade de 7 dias.
- **Forma:** O coeficiente de **assimetria foi de -0,16**, valor próximo de zero e indicativo de uma distribuição aproximadamente simétrica. A **curtose de 2,31** caracteriza a distribuição como **platicúrtica**, segundo a classificação adotada na revisão teórica.
### Limitações da Análise Descritiva
Embora a Estatística Descritiva permita quantificar e identificar matematicamente tendências, dispersões e características da distribuição dos dados, **ela não determina isoladamente as causas físicas desses comportamentos**.
A interpretação das variações observadas deve ser associada ao conhecimento tecnológico e de engenharia sobre o concreto. Entre os fatores que podem influenciar os resultados estão a relação água/cimento, características dos materiais constituintes, condições de produção e transporte, procedimentos de moldagem, condições de cura e execução dos ensaios, além da calibração dos equipamentos utilizados.
Dessa forma, os resultados estatísticos devem ser interpretados como uma caracterização do conjunto de dados analisado, e não como uma determinação isolada das causas responsáveis pelos comportamentos observados.
---
# 🧠 Considerações Finais
A utilização da linguagem computacional **R**, associada ao pacote **leem**, mostrou-se adequada para a organização, tratamento e análise dos dados obtidos nos ensaios de concreto. A utilização de procedimentos computacionais permitiu automatizar cálculos estatísticos, organizar os dados em distribuições de frequência e produzir diferentes representações gráficas, proporcionando maior reprodutibilidade à análise.
A aplicação prática sobre as 30 séries experimentais permitiu identificar diferentes comportamentos entre o estado fresco e o estado endurecido do concreto. O **slump** apresentou baixa variabilidade relativa, com **CV de 5,23%**, indicando pequena dispersão dos valores de abatimento em relação à média.
A **resistência aos 7 dias** apresentou maior dispersão relativa, com **CV de 13,08%**, além de assimetria negativa de $g_1 = -0,81$. Esse comportamento demonstra que a análise da resistência inicial deve considerar não apenas sua tendência central, mas também a variabilidade existente entre os resultados.
Aos **14 dias**, observou-se aumento da resistência média para **24,14 MPa**, acompanhado de redução significativa da dispersão. O **CV passou para 5,22%**, enquanto a assimetria se aproximou de zero, atingindo $g_1 = -0,16$. Esses resultados indicam que, para o conjunto analisado, os resultados aos 14 dias apresentaram maior uniformidade em relação aos obtidos aos 7 dias.
O estudo também evidencia que a utilização isolada da **média aritmética** é insuficiente para caracterizar adequadamente um conjunto de resultados experimentais. A avaliação conjunta das medidas de **posição**, **dispersão** e **forma** fornece uma visão mais abrangente do comportamento dos dados e permite identificar características que poderiam permanecer ocultas quando apenas a média é considerada.
Por fim, destaca-se que as ferramentas computacionais não substituem o conhecimento estatístico nem o julgamento crítico do profissional. O principal benefício da utilização do R está na possibilidade de integrar os fundamentos teóricos da Estatística aos procedimentos computacionais, permitindo transformar dados experimentais em informações quantitativas que auxiliam a interpretação técnica e a tomada de decisões na Engenharia Civil.
# 📖 Referências
::: {#refs}