---
# Só mude aqui!!!!
author: "Marco Antônio e Matheus Villela"
title: "Relatório 03 - Aula prática 03"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/eait/' target='_blank'>Estatística Aplicada a Inovações Tecnológicas (UFSJ)</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
toc-title: "Sumário" # Define o nome do sumário
toc-location: left # Coloca o sumário no lado esquerdo (opcional)
number-sections: true
theme: bootstrap
#css: styles.css
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
# 📌 Introdução
No **controle tecnológico do concreto**, a qualidade das decisões técnicas depende diretamente da confiabilidade dos dados obtidos em campo e em laboratório. Em situações reais, essas informações podem apresentar **valores ausentes, erros de digitação, inconsistências de preenchimento, diferentes formas de representação dos mesmos dados e valores aparentemente incompatíveis com o fenômeno analisado**. Quando esses problemas não são identificados e tratados adequadamente, podem comprometer os resultados estatísticos e conduzir a interpretações equivocadas.
Dessa forma, o processamento e a organização dos dados constituem etapas fundamentais antes da realização de análises estatísticas. O engenheiro deve ser capaz de **inspecionar, diagnosticar, limpar, transformar e explorar os dados**, garantindo que as informações utilizadas nas análises sejam consistentes e adequadas ao contexto da Engenharia Civil.
Nesta atividade, é utilizada a mesma base de dados relacionada ao **controle tecnológico do concreto**, composta por **100 observações e 10 variáveis**. Cada registro representa um corpo de prova ou informação de controle, enquanto as variáveis descrevem características como obra, tipo de concreto, idade, resistência à compressão, consumo de cimento, relação água/cimento, abatimento, densidade e absorção do agregado.
Diferentemente do relatório anterior, que priorizou as ferramentas do **Base R**, este trabalho utiliza prioritariamente a **família tidyverse**, explorando recursos para manipulação, transformação, organização, tratamento de textos, processamento e visualização dos dados.
Assim, busca-se demonstrar como ferramentas como `dplyr`, `tidyr`, `stringr`, `readr`, `purrr` e `ggplot2` podem ser utilizadas para transformar uma base de dados inicialmente bruta em **informações organizadas, interpretáveis e úteis para a tomada de decisão na Engenharia Civil**.
# 🎯 Objetivo geral
Desenvolver um fluxo de **inspeção, diagnóstico, limpeza, transformação e exploração de uma base de dados do controle tecnológico do concreto**, utilizando prioritariamente ferramentas da **família tidyverse no R**, de modo a transformar dados brutos em informações confiáveis para auxiliar na **tomada de decisão técnica na Engenharia Civil**.
## Objetivos específicos
* **Conhecer a estrutura da base**, identificando suas observações, variáveis, tipos de dados e valores ausentes.
* **Identificar inconsistências nos dados**, como erros de digitação, valores inadequados, problemas de padronização e registros incompatíveis com o contexto da Engenharia Civil.
* **Limpar e padronizar a base**, corrigindo variáveis qualitativas e quantitativas e tratando os valores ausentes de maneira tecnicamente justificável.
* **Utilizar ferramentas do `dplyr`** para filtrar, selecionar, transformar, agrupar e resumir os dados.
* **Criar novas variáveis** por meio de `mutate()` e `case_when()`, permitindo análises complementares do desempenho do concreto.
* **Aplicar ferramentas de `stringr` e `readr`** para o tratamento de textos e a conversão adequada de valores numéricos.
* **Utilizar `across()` e outras ferramentas do tidyverse** para realizar operações de forma sistemática sobre diferentes variáveis.
* **Explorar relações entre as características do concreto**, incluindo resistência, consumo de cimento, relação água/cimento e idade dos corpos de prova.
* **Produzir representações gráficas utilizando `ggplot2`**, auxiliando na identificação de padrões e na interpretação dos resultados.
* **Gerar informações estatísticas relevantes para o engenheiro responsável**, relacionando os resultados obtidos ao contexto do controle tecnológico do concreto.
* **Desenvolver um script organizado e reprodutível**, permitindo que outro profissional compreenda e reproduza as etapas de processamento e análise realizadas.
# ⚙️ Metodologia
A metodologia adotada neste trabalho consiste no **processamento, organização, limpeza, transformação e exploração de uma base de dados relacionada ao controle tecnológico do concreto**, utilizando a linguagem **R**, com ênfase nas ferramentas da família **tidyverse**.
O fluxo de trabalho mantém a estrutura desenvolvida no Relatório 02, porém substitui progressivamente as funções do **Base R** por ferramentas voltadas à manipulação e análise organizada dos dados, como `dplyr`, `tidyr`, `stringr`, `readr` e `ggplot2`.
O desenvolvimento foi organizado em uma sequência lógica composta pelas etapas de:
1. **Importação e inspeção inicial dos dados**;
2. **Verificação das dimensões e estrutura da base**;
3. **Identificação de valores ausentes e inconsistências**;
4. **Investigação de possíveis erros nos dados**;
5. **Limpeza e padronização das variáveis**;
6. **Conversão dos tipos de dados**;
7. **Exploração dos dados com `dplyr`**;
8. **Criação e transformação de variáveis com `mutate()`**;
9. **Análise de dados agrupados**;
10. **Seleção e reorganização de variáveis**;
11. **Tratamento de textos e categorias com `stringr`**;
12. **Visualização dos dados com `ggplot2`**;
13. **Investigação de relações relevantes para a Engenharia Civil**;
14. **Elaboração de informações para apoio à tomada de decisão do engenheiro**.
As atividades foram desenvolvidas progressivamente ao longo das **38 questões propostas**, além do desafio final, permitindo aplicar as ferramentas do tidyverse em diferentes etapas do tratamento e da análise da base de dados.
## 📋 Etapas de desenvolvimento
**Questão 01 — Importação dos dados**
**Importe** a base de dados para o R e armazene-a no objeto `dados`. Em seguida, **utilize** funções da família tidyverse para verificar a correta importação e visualizar as primeiras e últimas observações da base.
**Questão 02 — Dimensões da base**
**Determine** as dimensões da base, identificando a quantidade de observações e variáveis existentes. Para isso, **utilize** funções compatíveis com o fluxo de trabalho do tidyverse.
**Questão 03 — Estrutura da base**
**Analise** a estrutura da base utilizando a função `glimpse()`, verificando os nomes das variáveis, seus tipos e uma amostra dos valores armazenados.
**Questão 04 — Resumo das variáveis**
**Realize** um resumo das variáveis da base, buscando identificar características relevantes, como valores mínimos e máximos, distribuição dos dados, categorias existentes e possíveis inconsistências.
**Questão 05 — Classificação das variáveis**
**Analise** as variáveis quanto aos seus tipos, diferenciando aquelas de natureza **quantitativa** das **qualitativas**, com base na estrutura identificada pelo R.
**Questão 06 — Valores ausentes**
**Investigue** a existência de valores ausentes na base, identificando sua quantidade, as variáveis afetadas e as respectivas observações. Para tornar a verificação sistemática, **utilize** a função `across()`.
**Questão 07 — Valores incompatíveis**
**Investigue** valores potencialmente incompatíveis com o contexto da Engenharia Civil, considerando variáveis como idade, resistência, abatimento, densidade, relação água/cimento e absorção. **Utilize** a função `filter()` para localizar os registros suspeitos.
**Questão 08 — Possíveis erros de digitação**
**Identifique** registros que apresentem características de possíveis erros de digitação. Para isso, **utilize** funções como `filter()` e `select()`, permitindo localizar e visualizar os registros completos.
**Questão 09 — Padronização da variável `obra`**
**Verifique** as categorias da variável `obra` utilizando `count()` e `distinct()`, buscando identificar diferenças de grafia, espaços ou outras inconsistências entre categorias que deveriam representar o mesmo bloco.
**Questão 10 — Padronização da variável `tipo_concreto`**
**Analise** as categorias da variável `tipo_concreto` para verificar se existem diferentes formas de representar uma mesma classe de concreto.
**Questão 11 — Verificação dos tipos após o diagnóstico**
Após identificar os problemas, **verifique** novamente a estrutura da base utilizando `glimpse()` e outras funções apropriadas, avaliando como os erros encontrados podem influenciar a interpretação dos tipos das variáveis.
**Questão 12 — Criação da base limpa**
**Crie** uma cópia da base original denominada `dados_limpos`, preservando a base `dados` para garantir a possibilidade de comparação e recuperação das informações originais durante o processo de tratamento.
**Questão 13 — Limpeza das variáveis qualitativas**
**Padronize** as variáveis qualitativas utilizando funções do pacote `stringr`, como `str_trim()`, `str_to_upper()`, `str_replace()` e `str_replace_all()`. **Elimine** espaços indevidos e **uniformize** as categorias.
**Questão 14 — Conversão das variáveis quantitativas**
**Converta** as variáveis que deveriam ser quantitativas para seus tipos adequados. **Considere** problemas relacionados à utilização de vírgula decimal, caracteres indevidos e registros armazenados como texto, utilizando recursos do pacote `readr` quando apropriado.
**Questão 15 — Tratamento dos valores ausentes**
**Identifique** e **analise** individualmente os valores ausentes. **Considere** as possibilidades de exclusão da observação, substituição do valor, manutenção do `NA` ou consulta à fonte original, e **adote** a alternativa considerada mais adequada diante das informações disponíveis.
**Questão 16 — Verificação após a limpeza**
Após realizar o processo de limpeza, **verifique** novamente a estrutura e o resumo da base. **Confirme** as alterações realizadas e quais inconsistências foram corrigidas.
**Questão 17 — Resistência média**
**Calcule** a resistência média à compressão dos corpos de prova e, posteriormente, **determine** as médias considerando diferentes agrupamentos, como bloco da obra, tipo de concreto e idade do corpo de prova.
**Questão 18 — Comparação entre obras**
**Compare** as resistências médias entre os diferentes blocos da obra. **Organize** os resultados em ordem crescente ou decrescente utilizando `arrange()`, permitindo identificar os blocos com maior e menor resistência média.
**Questão 19 — Resistência por classe de concreto**
**Calcule** a resistência média para cada classe de concreto, considerando C25, C30, C35 e C40. **Organize** os resultados da maior para a menor resistência média.
**Questão 20 — Estatísticas por grupo**
**Calcule**, para cada tipo de concreto, as médias da resistência, consumo de cimento, relação água/cimento, abatimento e densidade. **Utilize** a combinação `group_by()` e `summarise()` para realizar as análises agrupadas.
**Questão 21 — Resistência relativa**
**Crie** a variável `resistencia_relativa`, representando a razão entre a resistência observada e uma resistência de referência associada à classe do concreto. Para estabelecer os valores de referência e realizar a classificação, **utilize** as funções `mutate()` e `case_when()`.
**Questão 22 — Classificação dos corpos de prova**
**Crie** a variável `classificacao`, destinada a classificar os corpos de prova segundo critérios relacionados à resistência. **Defina** e **justifique** os limites adotados considerando o objetivo da análise.
**Questão 23 — Resistência acima da média**
**Crie** a variável `acima_media`, assumindo os valores `TRUE` ou `FALSE`, indicando se a resistência de cada corpo de prova está acima da média de seu respectivo tipo de concreto. **Utilize** `group_by()` em conjunto com `mutate()`.
**Questão 24 — Quantidade de observações por grupo**
**Determine** a quantidade de observações existente em cada categoria de `tipo_concreto`, utilizando `group_by()` e `summarise()` para produzir uma tabela organizada.
**Questão 25 — Média por tipo de concreto**
**Calcule** a resistência média para cada tipo de concreto e, posteriormente, **ordene** os resultados utilizando `arrange()`, facilitando a comparação entre os grupos.
**Questão 26 — Estatísticas descritivas por grupo**
**Calcule** diferentes estatísticas da resistência à compressão para cada tipo de concreto, incluindo número de observações, média, mediana, desvio-padrão, mínimo e máximo. **Utilize** essas medidas para realizar uma análise mais completa do comportamento dos dados.
**Questão 27 — Seleção das variáveis quantitativas**
**Selecione** as variáveis quantitativas relacionadas às propriedades do concreto utilizando `select()`, podendo combiná-la com `where()` ou `all_of()`. **Crie** uma tabela contendo somente as informações relevantes para as análises quantitativas.
**Questão 28 — Cálculo de médias com `across()`**
**Utilize** a função `across()` para calcular simultaneamente as médias das variáveis quantitativas selecionadas. **Compare** o resultado com a realização individual das mesmas operações, avaliando a facilidade de manutenção do código.
**Questão 29 — Transformação simultânea de variáveis**
**Realize** uma transformação simultânea em um conjunto de variáveis quantitativas utilizando `mutate()` e `across()`. **Escolha** a transformação de acordo com o objetivo da análise e sua utilidade no tratamento dos dados.
**Questão 30 — Estatísticas múltiplas com `across()`**
**Utilize** a combinação de `across()` e `summarise()` para calcular diferentes estatísticas das variáveis quantitativas, agrupadas por tipo de concreto. **Reduza** a repetição de comandos e **organize** o código.
**Questão 31 — Padronização de textos**
**Investigue** e **padronize** a variável `obra` utilizando funções do pacote `stringr`. **Verifique** situações envolvendo espaços, diferenças entre letras maiúsculas e minúsculas e diferentes grafias para uma mesma categoria.
**Questão 32 — Identificação de padrões textuais**
**Utilize** a função `str_detect()` para localizar registros contendo determinados padrões textuais nas variáveis `tipo_concreto` ou `obra`. **Utilize** essa abordagem como ferramenta auxiliar para identificar inconsistências na base.
**Questão 33 — Distribuição da resistência**
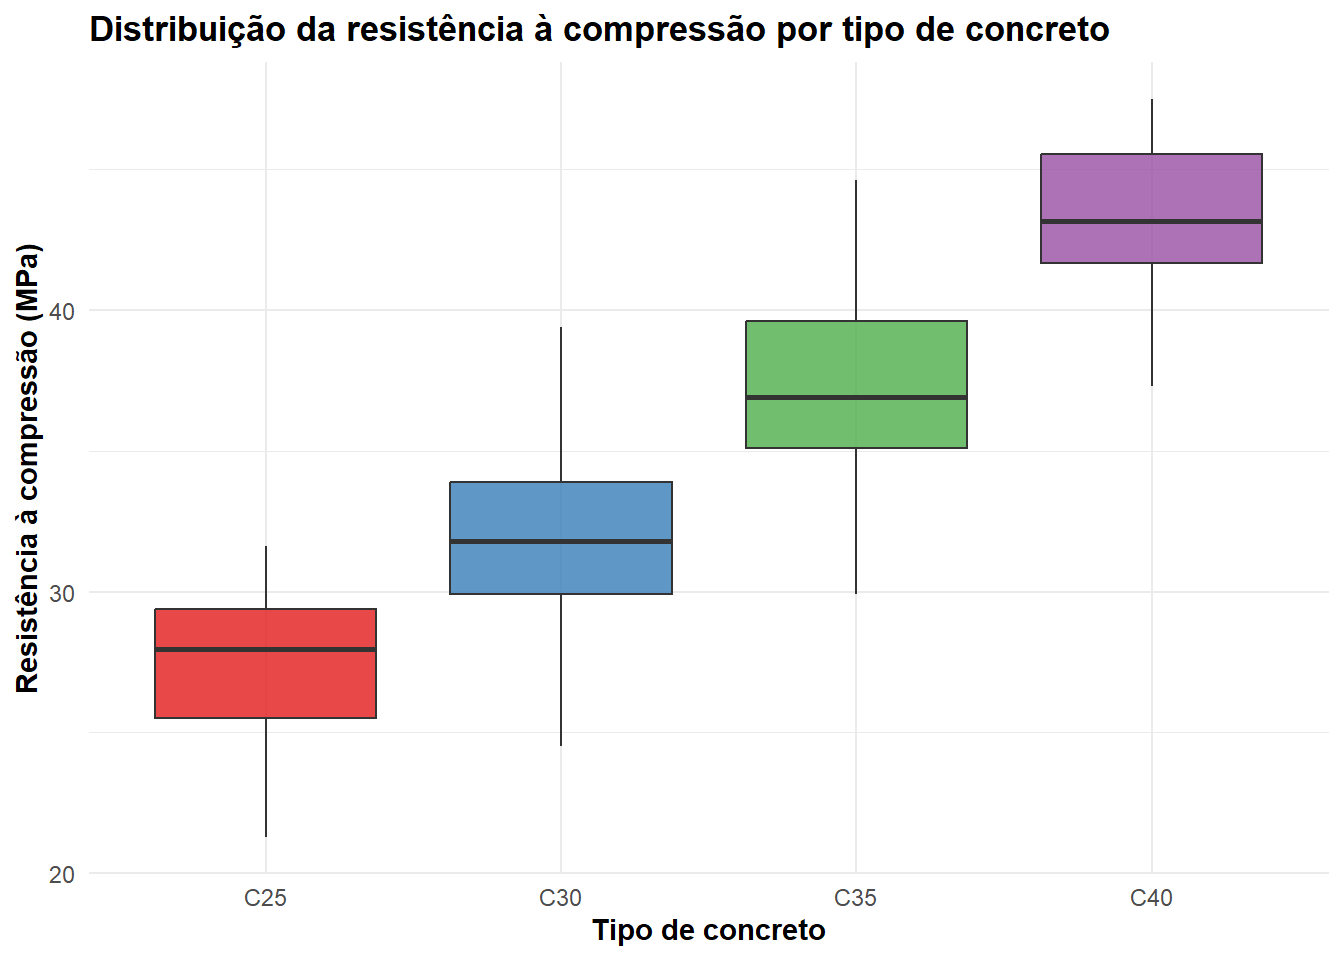
**Elabore** um gráfico utilizando `ggplot2` e `geom_boxplot()` para comparar a distribuição da resistência à compressão entre os diferentes tipos de concreto. **Avalie** diferenças de tendência central, dispersão e possíveis valores discrepantes.
**Questão 34 — Consumo de cimento e resistência**
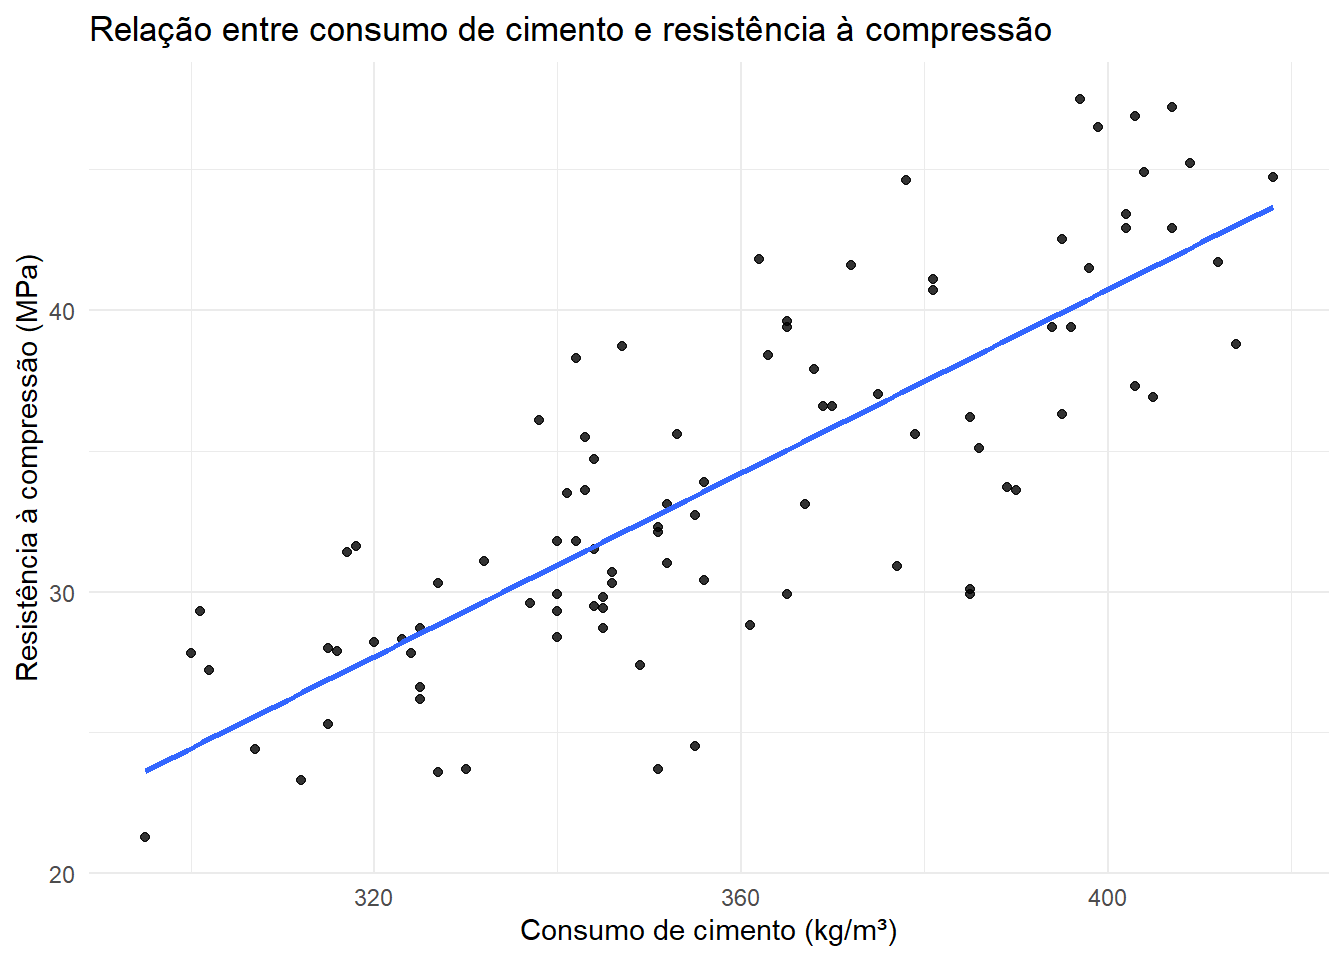
**Elabore** um gráfico de dispersão utilizando `geom_point()` para investigar a relação entre o consumo de cimento e a resistência à compressão. Quando apropriado, **adicione** uma linha de tendência para auxiliar na identificação do comportamento dos dados.
**Questão 35 — Relação água/cimento e resistência**
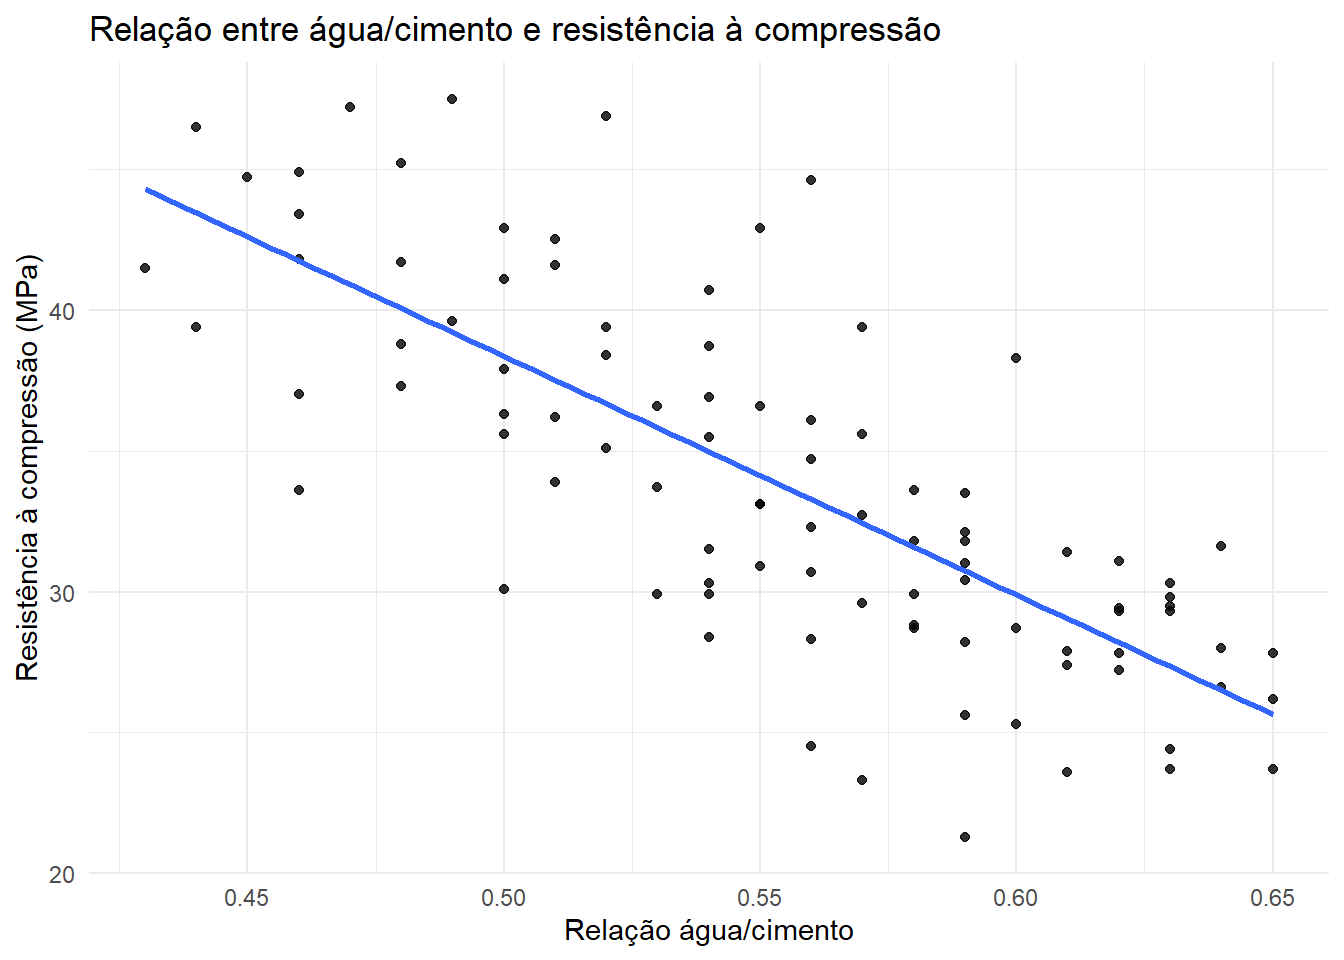
**Elabore** um gráfico utilizando `ggplot2` para investigar a relação entre a relação água/cimento e a resistência à compressão. **Analise** o comportamento observado, buscando identificar tendências relevantes para o controle tecnológico do concreto.
**Questão 36 — Comparação entre obras**
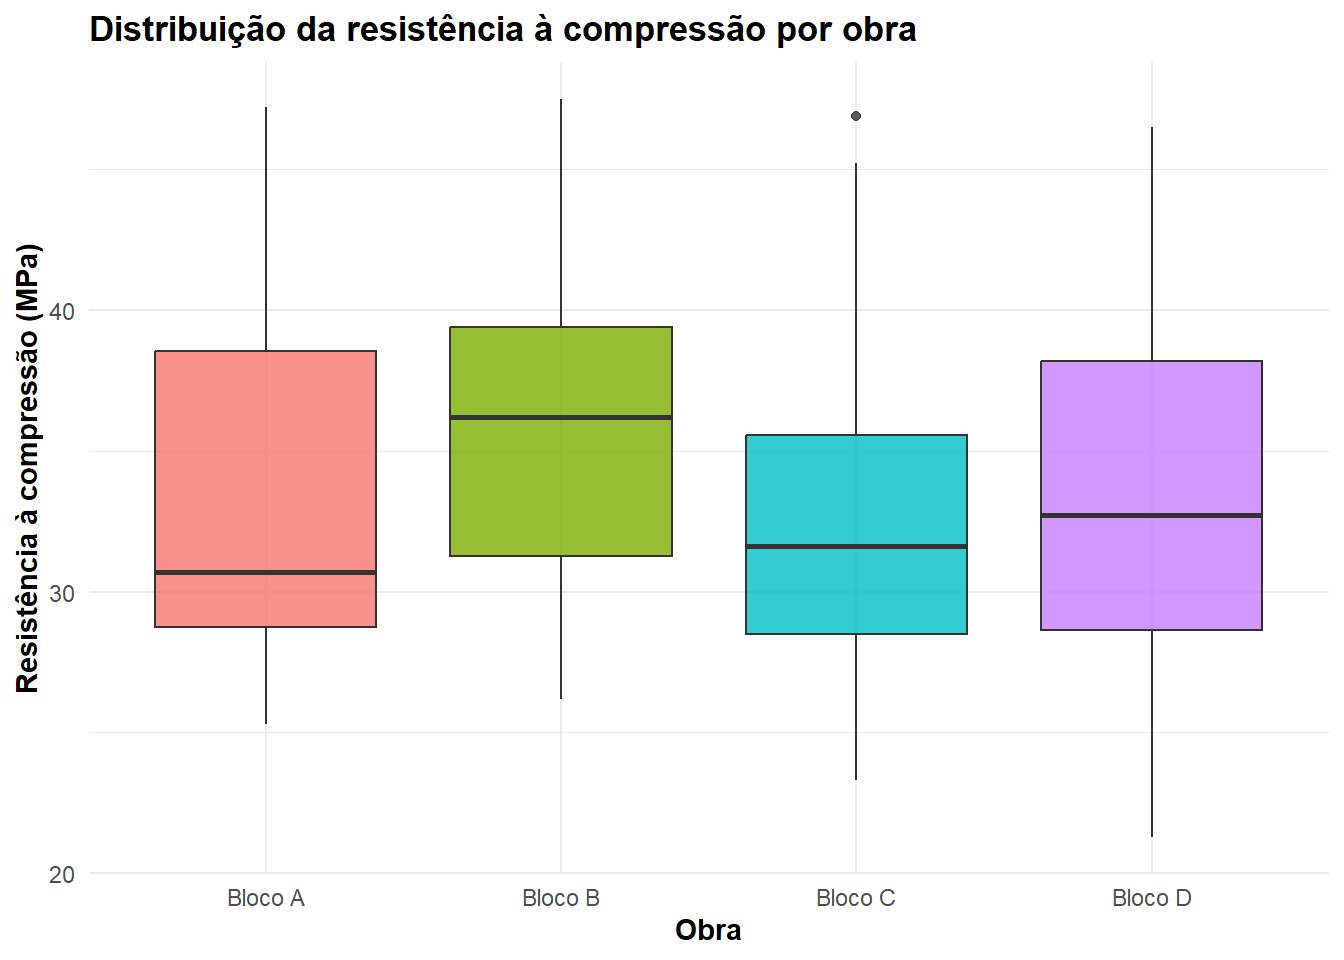
**Investigue**, de forma descritiva, a afirmação de que os concretos utilizados no Bloco C apresentam desempenho superior aos demais blocos. **Combine** ferramentas do `dplyr` e `ggplot2` para comparar os resultados entre as obras.
**Questão 37 — Idade e resistência**
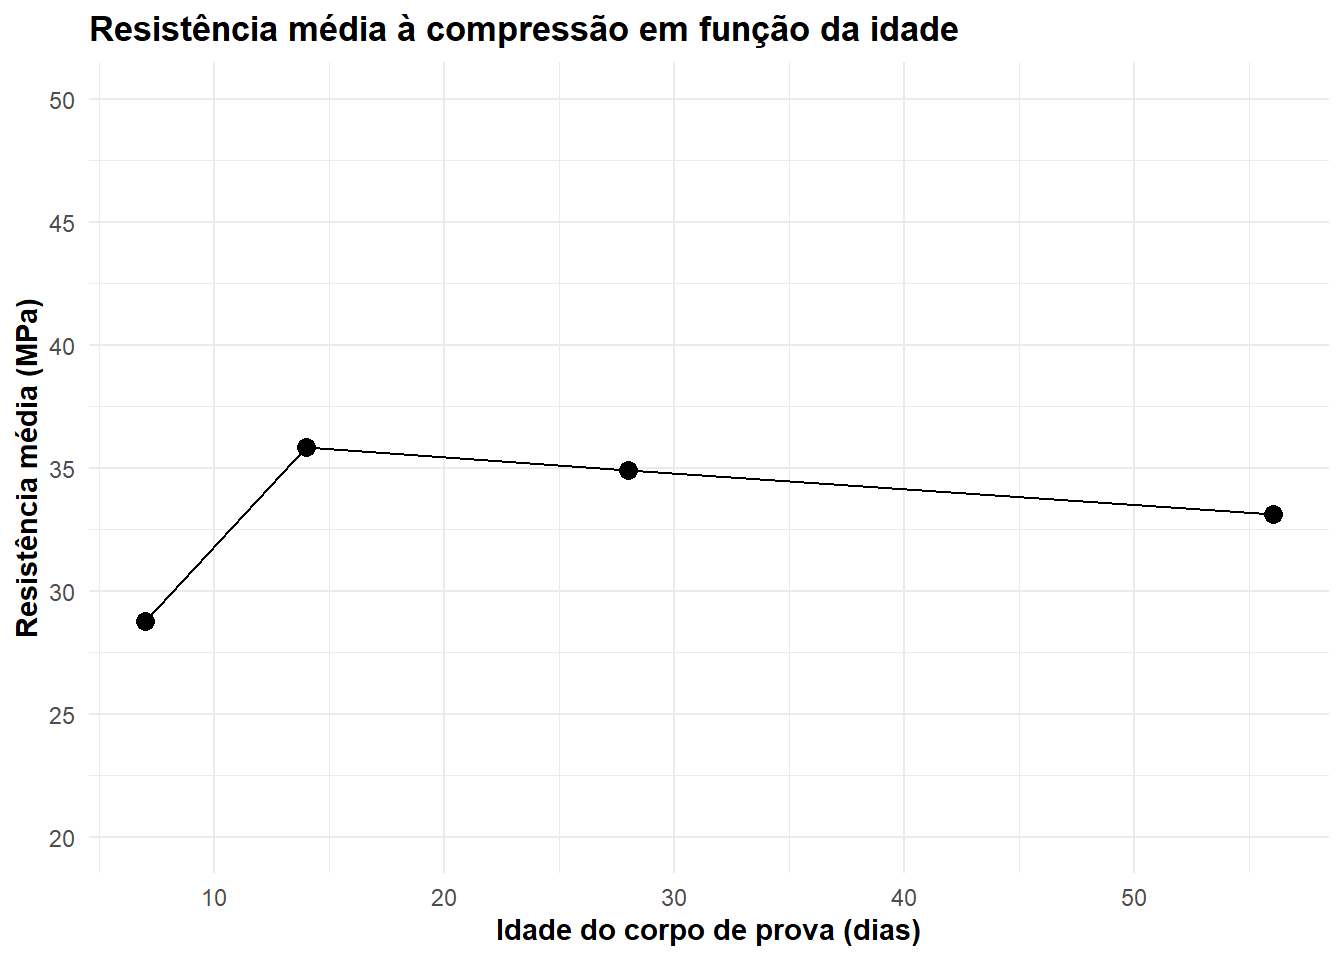
**Analise** a resistência média dos corpos de prova em diferentes idades utilizando `group_by()` e `summarise()`. Em seguida, **represente** os resultados graficamente para investigar o comportamento da resistência em função do aumento da idade.
**Questão 38 — Resumo para o engenheiro**
**Elabore** uma tabela-resumo contendo informações estatísticas consideradas relevantes para o acompanhamento da qualidade do concreto. **Justifique** as informações selecionadas de acordo com sua utilidade para a interpretação dos resultados e apoio à tomada de decisão do engenheiro.
## 🏗️ Desafio final — O engenheiro responsável pelos dados
Como etapa final, **desenvolva** um **script organizado em R**, utilizando prioritariamente ferramentas da família **tidyverse**, capaz de reproduzir as principais etapas realizadas ao longo do relatório.
O script deverá contemplar:
1. **Inspeção inicial da base**;
2. **Identificação de possíveis problemas**;
3. **Verificação de valores ausentes**;
4. **Identificação de inconsistências**;
5. **Produção de uma versão limpa dos dados**;
6. **Geração de estatísticas descritivas**;
7. **Criação de variáveis derivadas**;
8. **Produção de representações gráficas**;
9. **Geração de informações úteis ao engenheiro responsável pela obra**.
O código deverá ser organizado de maneira sequencial e documentada, permitindo que outro profissional consiga compreender as etapas realizadas, as transformações aplicadas e as decisões tomadas durante o tratamento da base.
# 📚 Fundamentação teórica
A **Estatística Descritiva** compreende métodos utilizados para resumir e interpretar dados por meio de medidas de posição, dispersão e representação gráfica [@batista2024estatistica]. Esses recursos permitem identificar padrões, variações e diferenças entre os dados analisados.
Na análise de dados da **Engenharia Civil**, essas ferramentas contribuem para a interpretação de resultados experimentais e para a identificação de comportamentos que possam auxiliar na avaliação dos materiais e processos construtivos.
O **R**, por meio de ferramentas do **tidyverse**, possibilita organizar, tratar, transformar e analisar os dados de forma sistemática [@batista2023rbasico]. Sua aplicação facilita a realização das análises estatísticas e a representação dos resultados.
Assim, os conceitos estatísticos e as ferramentas computacionais empregados neste relatório fornecem suporte para a análise e interpretação dos dados de controle tecnológico do concreto.
# 🔍 Resultados e Discussão
## Questão 1
A base de dados foi importada para o R utilizando a função `read_csv2()`, que é adequada ao arquivo por utilizar o ponto e vírgula (`;`) como separador. Optou-se por importar inicialmente todas as variáveis como texto, preservando os valores originais e evitando conversões automáticas antes da etapa de limpeza. O argumento `trim_ws = FALSE` foi mantido para preservar os espaços presentes nos dados.
```{r}
library(tidyverse)

dados <- read_csv2(
  "base_de_dados.csv",
  col_types = cols(.default = col_character()),
  trim_ws = FALSE
)

print(head(dados), width = Inf)
print(tail(dados), width = Inf)
```
As funções `head()` e `tail()` foram utilizadas para verificar as primeiras e últimas observações da base. A importação como texto permite identificar e corrigir as inconsistências existentes antes da conversão das variáveis para seus respectivos tipos.
## Questão 2
As dimensões da base foram verificadas por meio das funções `nrow()` e `ncol()`. A função `nrow()` retorna o número de linhas, correspondente às **observações**, enquanto `ncol()` retorna o número de colunas, correspondente às **variáveis**.
```{r}
nrow(dados)
ncol(dados)
```
A base apresentou **100 observações e 10 variáveis**. Dessa forma, cada linha representa uma observação e cada coluna corresponde a uma variável utilizada na análise.
## Questão 3
A estrutura da base foi apresentada por meio da função `glimpse()`, pertencente ao **tidyverse**. Essa função permite visualizar de forma resumida o número de observações, as variáveis existentes, os tipos atribuídos pelo R e alguns dos valores armazenados.
```{r}
glimpse(dados)
```
A análise da estrutura permitiu verificar que a base possui **100 observações e 10 variáveis**. Como todas as colunas foram importadas inicialmente como texto, as variáveis foram apresentadas pelo R com o tipo `<chr>`.
Essa escolha foi realizada para preservar os valores originais da base e evitar conversões automáticas antes da identificação dos problemas existentes. Dessa forma, a classificação das variáveis quanto à sua natureza será realizada considerando o significado das informações armazenadas.
## Questão 4
Para apresentar um resumo inicial das variáveis, foi verificada a quantidade de valores distintos presentes em cada coluna. Como todas as variáveis foram importadas como texto, essa abordagem permite investigar a diversidade dos valores sem realizar conversões antecipadas.
```{r}
dados %>%
  summarise(
    across(
      everything(),
      ~n_distinct(.x)
    )
  ) %>%
  print(width = Inf)
```
A função `across()` permite aplicar a mesma operação a todas as variáveis da base, enquanto `n_distinct()` contabiliza a quantidade de valores diferentes presentes em cada coluna.
O resultado permite identificar características iniciais da base, como a existência de diferentes categorias nas variáveis qualitativas e a quantidade de valores distintos nas variáveis que possuem natureza quantitativa.
Algumas variáveis apresentam valores com diferentes formas de preenchimento, como o uso de vírgula decimal, espaços adicionais e caracteres indevidos. Essas situações serão investigadas nas etapas seguintes.
Em comparação com o Relatório 02, a função `summary()` apresenta um resumo mais direto dos dados. Neste relatório, os recursos do `tidyverse` permitem realizar uma investigação mais direcionada, selecionando e transformando as informações conforme a necessidade da análise.
## Questão 5
Como todas as variáveis foram importadas inicialmente como texto, o tipo atribuído pelo R foi verificado utilizando `across()` em conjunto com `class()`.
```{r}
dados %>%
  summarise(
    across(
      everything(),
      ~class(.x)[1]
    )
  ) %>%
  print(width = Inf)
```
A função `everything()` seleciona todas as colunas da base, enquanto `across()` aplica a função `class()` a cada variável.
Como resultado, todas as variáveis foram reconhecidas inicialmente pelo R como `character`. Entretanto, o tipo de armazenamento não determina, por si só, a natureza estatística da variável.
Considerando a natureza das informações, as variáveis podem ser classificadas da seguinte forma:
| Natureza | Variáveis |
| ----------------- | ---------------------------------------------------------------------------------------------------------------------------- |
| **Qualitativas** | `id_corpo_prova`, `obra`, `tipo_concreto` |
| **Quantitativas** | `idade_dias`, `resistencia_mpa`, `cimento_kg_m3`, `relacao_a_c`, `abatimento_mm`, `densidade_kg_m3`, `absorção_agregado_pct` |
Assim, as sete últimas variáveis possuem natureza quantitativa, embora estejam temporariamente armazenadas como texto. Essa conversão será realizada após a identificação e correção das inconsistências presentes na base.
## Questão 6
A existência de valores ausentes na base foi investigada utilizando `across()` em conjunto com `is.na()`. Essa abordagem permite realizar uma verificação sistemática de todas as variáveis.
Inicialmente, foi calculada a quantidade de valores ausentes em cada variável:
```{r}
ausentes_variaveis <- dados %>%
  summarise(
    across(
      everything(),
      ~sum(is.na(.x))
    )
  ) %>%
  pivot_longer(
    cols = everything(),
    names_to = "variavel",
    values_to = "quantidade_ausentes"
  ) %>%
  filter(quantidade_ausentes > 0)

knitr::kable(
  ausentes_variaveis,
  col.names = c(
    "Variável",
    "Quantidade de valores ausentes"
  ),
  caption = "Variáveis que apresentam valores ausentes"
)
```
Foram identificados **5 valores ausentes**, distribuídos entre as variáveis `resistencia_mpa`, `relacao_a_c`, `abatimento_mm`, `densidade_kg_m3` e `absorção_agregado_pct`.
Para localizar as respectivas observações, foi utilizado:
```{r}
dados %>%
  mutate(observacao = row_number()) %>%
  pivot_longer(
    cols = -c(observacao, id_corpo_prova),
    names_to = "variavel",
    values_to = "valor"
  ) %>%
  filter(is.na(valor)) %>%
  select(observacao, id_corpo_prova, variavel)
```
Os valores ausentes foram localizados nas observações **15, 38, 77, 92 e 97**, correspondentes aos corpos de prova `CP-015`, `CP-038`, `CP-077`, `CP-092` e `CP-097`, respectivamente.
## Questão 7
A verificação dos valores potencialmente incompatíveis com o contexto da Engenharia Civil será realizada após a etapa de limpeza e conversão dos tipos das variáveis. Essa ordem permite que as variáveis inicialmente armazenadas como `character` sejam transformadas em valores numéricos antes da aplicação dos critérios de intervalo.
Dessa forma, após a correção das inconsistências de preenchimento e a conversão das variáveis quantitativas, será possível avaliar os valores de forma adequada, utilizando intervalos de referência para identificar observações que merecem investigação.
## Questão 8
Os registros foram investigados em busca de possíveis erros de digitação ou problemas de preenchimento. Para isso, foram utilizadas as funções `filter()`, `select()` e recursos do `stringr`.
```{r}
dados %>%
  filter(
    str_detect(resistencia_mpa, "[^0-9.]") |
    str_detect(cimento_kg_m3, "[^0-9.]") |
    str_detect(relacao_a_c, ",")
  ) %>%
  select(
    id_corpo_prova,
    obra,
    tipo_concreto,
    resistencia_mpa,
    cimento_kg_m3,
    relacao_a_c
  ) %>%
  print(width = Inf)
```
A investigação permitiu identificar registros que apresentam caracteres ou formatos diferentes do padrão predominante da base. Entre eles, destacam-se `38,7`, `3O,4`, `0,55` e `390O`.
Os registros que apresentam a letra **O** no lugar do algarismo **0**, como `3O,4` e `390O`, caracterizam possíveis erros de digitação. Já os valores `38,7` e `0,55` apresentam apenas uma diferença no separador decimal em relação ao padrão utilizado na maior parte da base.
Essas inconsistências devem ser corrigidas antes da conversão das variáveis para o tipo numérico.
## Questão 9
As categorias da variável `obra` foram verificadas utilizando `count()` e `distinct()`, buscando identificar diferenças de grafia, espaços ou outras inconsistências.
```{r}
dados %>%
  count(obra)
```
Em seguida, foram apresentadas as categorias existentes:
```{r}
dados %>%
  distinct(obra)
```
A análise permitiu identificar as categorias utilizadas na variável `obra` e verificar possíveis diferenças de preenchimento. Foi identificada uma ocorrência de `Bloco B` com espaço adicional ao final do texto, que representa a mesma categoria das demais ocorrências de `Bloco B`.
Essa inconsistência de preenchimento deverá ser corrigida durante a etapa de padronização das variáveis qualitativas.
## Questão 10
As categorias da variável `tipo_concreto` foram verificadas utilizando `count()` e `distinct()`.
```{r}
dados %>%
  count(tipo_concreto)
```
```{r}
dados %>%
  distinct(tipo_concreto)
```
A análise das categorias permitiu identificar as diferentes formas de preenchimento da variável. Foi encontrada a categoria `c30`, que representa o mesmo tipo de concreto que `C30`, mas apresenta diferença entre letras maiúsculas e minúsculas.
Dessa forma, a categoria `c30` deverá ser padronizada para `C30` durante a etapa de limpeza dos dados.
## Questão 11
Após a identificação dos problemas presentes na base, os tipos das variáveis foram novamente verificados por meio da função `glimpse()`.
```{r}
glimpse(dados)
```
Como todas as variáveis foram importadas inicialmente como texto, elas permanecem classificadas como `<chr>` neste momento. Entretanto, a análise realizada nas questões anteriores mostrou que várias dessas variáveis possuem natureza quantitativa.
Um dos motivos para uma variável quantitativa ser armazenada como texto é a presença de valores que fogem ao padrão esperado, como vírgulas decimais, caracteres indevidos ou diferentes formas de preenchimento.
Um único valor digitado incorretamente pode alterar a maneira como o R interpreta uma variável inteira quando a importação depende da identificação automática dos tipos. Por esse motivo, a importação inicial como texto permite preservar os registros originais e realizar o tratamento dos problemas antes da conversão.
## Questão 12
Foi criada uma cópia da base original chamada `dados_limpos`.
```{r}
dados_limpos <- dados
```
A preservação da base original é importante porque permite comparar os dados antes e depois das alterações, além de possibilitar a recuperação das informações originais caso alguma transformação seja realizada de forma inadequada.
Dessa forma, as alterações necessárias serão realizadas somente no objeto `dados_limpos`, mantendo `dados` como referência da base originalmente importada.
## Questão 13
As variáveis qualitativas foram padronizadas utilizando funções do pacote `stringr`. Inicialmente, foram removidos espaços adicionais e uniformizadas as letras das categorias.
```{r}
dados_limpos <- dados_limpos %>%
  mutate(
    obra = str_trim(obra),
    obra = str_squish(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto))
  )
```
Após a transformação, as categorias podem ser verificadas novamente:
```{r}
dados_limpos %>%
  count(obra)
dados_limpos %>%
  count(tipo_concreto)
```
A utilização de `str_trim()` permite remover espaços no início e no final dos textos, enquanto `str_squish()` elimina espaços adicionais entre as palavras. A função `str_to_upper()` foi utilizada para uniformizar as letras da variável `tipo_concreto`.
Com essas transformações, categorias que representavam a mesma informação, mas apresentavam diferenças de preenchimento, passam a seguir um padrão único.
## Questão 14
Após a identificação e correção das inconsistências, as variáveis que possuem natureza quantitativa foram convertidas para o tipo numérico. Para isso, foram utilizados recursos do pacote `readr`.
Antes da conversão, os valores que apresentam vírgula decimal ou caracteres indevidos foram corrigidos:
```{r}
dados_limpos <- dados_limpos %>%
  mutate(
    resistencia_mpa = str_replace_all(resistencia_mpa, "O", "0"),
    resistencia_mpa = str_replace_all(resistencia_mpa, ",", "."),
    cimento_kg_m3 = str_replace_all(cimento_kg_m3, "O", "0"),
    relacao_a_c = str_replace_all(relacao_a_c, ",", ".")
  )
```
Em seguida, as variáveis foram convertidas para o tipo numérico:
```{r}
dados_limpos <- dados_limpos %>%
  mutate(
    idade_dias = parse_integer(idade_dias),
    resistencia_mpa = parse_double(resistencia_mpa),
    cimento_kg_m3 = parse_double(cimento_kg_m3),
    relacao_a_c = parse_double(relacao_a_c),
    abatimento_mm = parse_double(abatimento_mm),
    densidade_kg_m3 = parse_double(densidade_kg_m3),
    absorção_agregado_pct = parse_double(absorção_agregado_pct)
  )
```
A estrutura da base foi verificada novamente para confirmar a conversão:
```{r}
glimpse(dados_limpos)
```
A conversão permitiu que as variáveis quantitativas passassem a ser armazenadas como valores numéricos, possibilitando a realização das análises estatísticas nas etapas seguintes. Os valores ausentes permaneceram como `NA`, sendo tratados posteriormente de acordo com a estratégia definida para a base.
### Verificação dos intervalos dos valores
Após a padronização e conversão das variáveis quantitativas, foram verificados valores potencialmente incompatíveis com o contexto do controle tecnológico do concreto.
Para essa análise, foram utilizados como referência os intervalos adotados no Relatório 02. Esses limites representam uma **triagem inicial** dos dados, permitindo identificar observações que merecem investigação, mas não determinam, isoladamente, que um valor esteja incorreto.
Os intervalos considerados foram:
| Variável | Intervalo de referência |
| ----------------------- | ----------------------: |
| `idade_dias` | 1 a 56 dias |
| `resistencia_mpa` | 20 a 60 MPa |
| `abatimento_mm` | 10 a 220 mm |
| `densidade_kg_m3` | 2000 a 2600 kg/m³ |
| `relacao_a_c` | 0,40 a 0,70 |
| `absorção_agregado_pct` | 0 a 10% |
A verificação foi realizada utilizando `filter()`:
```{r}
dados_limpos %>%
  filter(
    idade_dias <= 0 | idade_dias > 56 |
    resistencia_mpa < 20 | resistencia_mpa > 60 |
    abatimento_mm < 10 | abatimento_mm > 220 |
    densidade_kg_m3 < 2000 | densidade_kg_m3 > 2600 |
    relacao_a_c < 0.40 | relacao_a_c > 0.70 |
    absorção_agregado_pct < 0 | absorção_agregado_pct > 10
  ) %>%
  print(width = Inf)
```
O código permite localizar as observações que apresentam pelo menos uma variável fora dos intervalos estabelecidos. Entre os valores identificados na base estão a idade de **280 dias**, o abatimento de **1250 mm**, a densidade de **238 kg/m³** e a absorção de **18,4%**, que apresentam grande afastamento em relação aos demais registros.
Esses valores devem ser investigados antes da utilização da base nas análises estatísticas. Entretanto, sua identificação como valores fora do intervalo não implica que sejam automaticamente erros, sendo necessário considerar o contexto do ensaio e as características da base.
## Questão 15
Após a conversão das variáveis quantitativas, foi realizada uma investigação dos valores ausentes. Além dos valores `NA`, foram considerados registros como `N/A`, `NULL`, `null`, `-` e células vazias.
Para identificar esses registros sem alterar os tipos das variáveis em `dados_limpos`, foi criada uma base auxiliar:
```{r}
dados_ausentes <- dados_limpos %>%
  mutate(
    across(
      everything(),
      ~str_trim(as.character(.x))
    )
  ) %>%
  mutate(
    across(
      everything(),
      ~na_if(.x, "")
    )
  ) %>%
  mutate(
    across(
      everything(),
      ~ifelse(.x %in% c("NA", "N/A", "NULL", "null", "-"), NA, .x)
    )
  )
```
A quantidade de valores ausentes por variável foi verificada por:
```{r}
dados_ausentes %>%
  summarise(across(everything(), ~sum(is.na(.x)))) %>%
  pivot_longer(
    cols = everything(),
    names_to = "variavel",
    values_to = "quantidade_NA"
  ) %>%
  filter(quantidade_NA > 0)
```
Também foram identificadas as observações que apresentam pelo menos um valor ausente:
```{r}
dados_ausentes %>%
  filter(if_any(everything(), is.na)) %>%
  summarise(observacoes_com_ausentes = n())
```
Após a identificação, foram separadas as observações que apresentam valores ausentes:
```{r}
dados_excluidos <- dados_limpos %>%
  filter(if_any(everything(), is.na)) %>%
  print(width = Inf)
dados_limpos <- dados_limpos %>%
  filter(if_all(everything(), ~!is.na(.x)))
```
A base `dados_excluidos` preserva os registros retirados da análise, enquanto `dados_limpos` contém somente as observações completas.
### Justificativa
Optou-se pela **exclusão das observações que apresentam pelo menos um valor ausente**, evitando a criação de informações que não foram efetivamente medidas. Essa decisão é adequada à quantidade de dados disponíveis e mantém apenas observações completas para as análises posteriores.
Os registros excluídos foram preservados em `dados_excluidos`, garantindo a rastreabilidade do tratamento realizado. A base original `dados` também permanece preservada.
A utilização de uma base auxiliar para identificar os diferentes formatos de ausência evita que as variáveis numéricas de `dados_limpos` sejam novamente convertidas para `character`.
## Questão 16
Após a realização das etapas de limpeza e transformação, foi verificada novamente a estrutura da base `dados_limpos`. Essa etapa permite confirmar se as variáveis foram convertidas para os tipos adequados e se as principais inconsistências identificadas anteriormente foram tratadas.
```{r}
glimpse(dados_limpos)
```
A análise da estrutura permite verificar que as variáveis qualitativas permanecem como texto, enquanto as variáveis quantitativas passaram a ser reconhecidas pelo R como numéricas. Dessa forma, a base apresenta uma estrutura adequada para a realização das análises estatísticas posteriores.
Entre os principais tratamentos realizados estão:
* padronização das variáveis qualitativas;
* correção de diferenças de preenchimento;
* substituição de caracteres indevidos nos valores numéricos;
* padronização dos separadores decimais;
* conversão das variáveis quantitativas para o tipo numérico;
* manutenção dos valores ausentes como `NA`, para que sejam tratados de acordo com a estratégia definida para a análise.
A base original `dados` permanece preservada, enquanto `dados_limpos` contém as transformações realizadas durante o processo de tratamento. Essa separação permite manter a rastreabilidade das alterações e comparar os dados antes e depois da limpeza.
Portanto, após as etapas realizadas, `dados_limpos` apresenta uma estrutura mais consistente e adequada para as análises estatísticas seguintes.
## Questão 17
A resistência média à compressão dos corpos de prova foi calculada inicialmente considerando toda a base de dados. Em seguida, a média foi calculada separadamente de acordo com o bloco da obra, o tipo de concreto e a idade do corpo de prova.
```{r}
# Resistência média de todos os corpos de prova
dados_limpos |>
  summarise(
    resistencia_media = mean(resistencia_mpa)
  )
```
A resistência média também foi calculada para cada bloco da obra:
```{r}
# Resistência média por bloco da obra
dados_limpos |>
  group_by(obra) |>
  summarise(
    resistencia_media = mean(resistencia_mpa)
  )
```
Em seguida, foi calculada a resistência média para cada tipo de concreto:
```{r}
# Resistência média por tipo de concreto
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa)
  )
```
Por fim, foi calculada a resistência média para cada idade dos corpos de prova:
```{r}
# Resistência média por idade do corpo de prova
dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    resistencia_media = mean(resistencia_mpa)
  )
```
A função `group_by()` foi utilizada para dividir os dados de acordo com a variável de interesse, enquanto `summarise()` calculou a média da resistência à compressão em cada grupo. Dessa forma, é possível comparar o comportamento da resistência entre diferentes blocos da obra, tipos de concreto e idades dos corpos de prova.
Os resultados permitem observar como a resistência média varia conforme as características dos corpos de prova, possibilitando uma análise mais detalhada do comportamento do concreto na base estudada.
## Questão 18
Para comparar os blocos da obra, foi calculada a resistência média à compressão para cada bloco. Em seguida, os resultados foram ordenados de forma crescente, permitindo identificar diretamente o bloco com menor e maior resistência média.
```{r}
comparacao_obras <- dados_limpos |>
  group_by(obra) |>
  summarise(
    resistencia_media = mean(resistencia_mpa)
  ) |>
  arrange(resistencia_media)

comparacao_obras
```
O resultado apresenta os blocos organizados da **menor para a maior resistência média**. Assim, o primeiro bloco da tabela corresponde ao bloco que apresentou a menor resistência média, enquanto o último corresponde ao bloco que apresentou a maior resistência média.
Dessa forma, a utilização conjunta de `group_by()`, `summarise()` e `arrange()` permite realizar a comparação entre as obras de maneira simples e objetiva, facilitando a identificação dos blocos com os maiores e menores valores médios de resistência à compressão.
## Questão 19
Para comparar as classes de concreto, foram consideradas as classes C25, C30, C35 e C40. A resistência média foi calculada para cada classe e os resultados foram organizados em ordem decrescente.
```{r}
resultado_tipo <- dados_limpos |>
  filter(tipo_concreto %in% c("C25", "C30", "C35", "C40")) |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))

resultado_tipo
```
A função `filter()` seleciona apenas as quatro classes solicitadas. Em seguida, `group_by()` agrupa os corpos de prova de acordo com a classe do concreto, enquanto `summarise()` calcula a resistência média de cada grupo. Por fim, `arrange(desc())` organiza os resultados da maior para a menor resistência média.
A **primeira linha do resultado corresponde à classe que apresentou a maior resistência média**, permitindo identificar diretamente a classe de concreto com melhor desempenho médio entre as classes analisadas.
## Questão 20
Para comparar as diferentes classes de concreto, foram calculadas as médias da resistência à compressão, do consumo de cimento, da relação água/cimento, do abatimento e da densidade para cada tipo de concreto.
```{r}
estatisticas_concreto <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa),
    cimento_medio = mean(cimento_kg_m3),
    relacao_a_c_media = mean(relacao_a_c),
    abatimento_medio = mean(abatimento_mm),
    densidade_media = mean(densidade_kg_m3),
    .groups = "drop"
  ) %>%
  print(width = Inf)
```
A utilização de `group_by()` permite separar os corpos de prova de acordo com o tipo de concreto. Em seguida, `summarise()` calcula a média de cada variável dentro de cada grupo. O argumento `.groups = "drop"` é utilizado para que o resultado final não permaneça agrupado.
Os resultados permitem comparar o comportamento médio das principais características do concreto entre as diferentes classes. De modo geral, espera-se que as classes de maior resistência apresentem valores médios de resistência à compressão superiores. A relação água/cimento também é uma variável importante, pois relações menores tendem a estar associadas a maiores resistências, desde que os demais fatores de dosagem e cura sejam adequados.
O consumo médio de cimento, o abatimento e a densidade permitem complementar essa avaliação. Diferenças no abatimento podem indicar diferentes características de trabalhabilidade das misturas, enquanto a densidade permite verificar se existem diferenças significativas entre os concretos analisados.
Assim, a tabela obtida possibilita avaliar conjuntamente as principais características dos diferentes tipos de concreto, identificando diferenças entre as classes e permitindo relacioná-las com o desempenho mecânico observado.
## Questão 21
Foi criada a variável `resistencia_relativa`, representando a razão entre a resistência observada e a resistência de referência correspondente à classe do concreto.
Como critério, foi considerada a resistência nominal indicada pela classe do concreto: **25 MPa para C25, 30 MPa para C30, 35 MPa para C35 e 40 MPa para C40**.
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    resistencia_relativa = resistencia_mpa /
      case_when(
        tipo_concreto == "C25" ~ 25,
        tipo_concreto == "C30" ~ 30,
        tipo_concreto == "C35" ~ 35,
        tipo_concreto == "C40" ~ 40,
        TRUE ~ NA_real_
      )
  )

# Apresentação de apenas algumas observações para facilitar a visualização
dados_limpos |>
  select(
    id_corpo_prova,
    tipo_concreto,
    resistencia_mpa,
    resistencia_relativa
  ) |>
  slice_head(n = 10)
```
Foi apresentada somente uma amostra das observações no relatório para **evitar excesso de informações e poluição visual**, facilitando a compreensão do procedimento e da nova variável criada. Entretanto, o cálculo de `resistencia_relativa` foi realizado para **todas as observações da base `dados_limpos`**.
A função `case_when()` associa cada classe de concreto ao seu respectivo valor de referência. Em seguida, `mutate()` calcula a razão entre a resistência observada e a resistência de referência.
A interpretação é feita da seguinte forma: um valor de `resistencia_relativa` igual a **1,00** indica que a resistência observada corresponde à resistência de referência da classe. Valores **maiores que 1,00** indicam resistência observada superior à referência, enquanto valores **menores que 1,00** indicam resistência inferior à referência.
Por exemplo, um corpo de prova C35 com resistência de 36,3 MPa apresenta resistência relativa de aproximadamente **1,04**, indicando que sua resistência corresponde a aproximadamente 104% da resistência de referência de 35 MPa.
A resistência nominal da classe foi utilizada como referência por representar o valor associado à classificação do concreto, permitindo avaliar o desempenho observado de cada corpo de prova em relação à sua própria classe.
## Questão 22
[Para classificar os corpos de prova, foi utilizada a variável `resistencia_relativa`, criada na questão anterior. Dessa forma, cada resistência observada é comparada com a resistência de referência correspondente à sua classe de concreto.
Foram adotados os seguintes critérios:
* **Igual ou superior à referência:** `resistencia_relativa >= 1,00`;
* **Próxima da referência:** `0,90 <= resistencia_relativa < 1,00`;
* **Abaixo da referência:** `resistencia_relativa < 0,90`.
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    classificacao = case_when(
      resistencia_relativa >= 1.00 ~ "Igual ou superior à referência",
      resistencia_relativa >= 0.90 ~ "Próxima da referência",
      resistencia_relativa < 0.90 ~ "Abaixo da referência",
      TRUE ~ NA_character_
    )
  )

# Tabela para apresentação dos resultados
tabela_classificacao <- dados_limpos |>
  select(
    id_corpo_prova,
    tipo_concreto,
    resistencia_mpa,
    resistencia_relativa,
    classificacao
  )

knitr::kable(
  head(tabela_classificacao, 95),
  digits = 3,
  col.names = c(
    "Corpo de prova",
    "Tipo de concreto",
    "Resistência (MPa)",
    "Resistência relativa",
    "Classificação"
  ),
  caption = "Classificação dos corpos de prova segundo a resistência relativa."
)
```
A função `mutate()` foi utilizada para criar a variável `classificacao`, enquanto `case_when()` permite aplicar diferentes critérios de acordo com o valor de `resistencia_relativa`.
O valor **1,00** representa 100% da resistência de referência da classe. Portanto, valores iguais ou superiores a 1,00 indicam resistência observada igual ou superior à referência. Valores entre 0,90 e 1,00 foram considerados próximos da referência, enquanto valores inferiores a 0,90 foram classificados como abaixo da referência.
O limite de 10% foi adotado como **critério analítico para esta atividade**, permitindo diferenciar resultados próximos da referência daqueles que apresentam uma redução mais significativa. Esse critério não deve ser interpretado como um critério normativo de aceitação do concreto, mas como uma forma de organizar e interpretar os resultados da base de dados.
## Questão 23
Foi criada a variável `acima_media`, indicando se a resistência à compressão de cada corpo de prova está acima da resistência média de seu respectivo tipo de concreto.
Para isso, os dados foram agrupados por `tipo_concreto` e a média de resistência foi calculada automaticamente dentro de cada grupo.
```{r}
dados_limpos <- dados_limpos |>
  group_by(tipo_concreto) |>
  mutate(
    acima_media = resistencia_mpa > mean(resistencia_mpa)
  ) |>
  ungroup()

# Apresentação dos resultados
dados_limpos |>
  select(
    id_corpo_prova,
    tipo_concreto,
    resistencia_mpa,
    acima_media
  ) |>
  head(95) |>
  knitr::kable(
    digits = 2,
    col.names = c(
      "Corpo de prova",
      "Tipo de concreto",
      "Resistência (MPa)",
      "Acima da média"
    ),
    caption = "Classificação da resistência em relação à média do tipo de concreto."
  )
```
A função `group_by()` foi utilizada para separar os corpos de prova de acordo com o `tipo_concreto`. Em seguida, `mutate()` calcula a média da resistência dentro de cada grupo e compara cada valor observado com essa média.
A expressão `resistencia_mpa > mean(resistencia_mpa)` retorna diretamente um valor lógico: **`TRUE`** quando a resistência do corpo de prova está acima da média de seu tipo de concreto e **`FALSE`** quando está igual ou abaixo da média.
O procedimento atende ao desafio proposto, pois as médias de cada classe **não foram calculadas manualmente**. O próprio `group_by()` faz a separação dos grupos e `mean()` calcula automaticamente a média correspondente a cada tipo de concreto.
## Questão 24
Para determinar a quantidade de corpos de prova em cada tipo de concreto, os dados foram agrupados pela variável `tipo_concreto`. Em seguida, foi utilizada a função `summarise()` com `n()` para contar o número de observações pertencentes a cada grupo.
```{r}
observacoes_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    quantidade = n(),
    .groups = "drop"
  )

knitr::kable(
  observacoes_tipo,
  col.names = c("Tipo de concreto", "Quantidade de observações"),
  caption = "Quantidade de observações por tipo de concreto."
)
```
A função `group_by()` organiza as observações de acordo com o tipo de concreto, enquanto `summarise()` permite calcular a quantidade de registros de cada grupo. A função `n()` realiza a contagem das observações.
O resultado é apresentado em uma tabela para facilitar a visualização e comparação da quantidade de corpos de prova existentes em cada classe de concreto.
## Questão 25
Calculando a resistência média de cada tipo de concreto. Group_by() agrupa as observações de acordo com o tipo de concreto. Summarise() calcula a resistência média de cada grupo. Arrange() ordena os resultados da menor para a maior resistência média.
```{r}
resistencia_media_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa),
    .groups = "drop"
  ) |>
  arrange(resistencia_media)

# Apresentando os resultados em uma tabela organizada.
knitr::kable(
  resistencia_media_tipo,
  digits = 2,
  col.names = c(
    "Tipo de concreto",
    "Resistência média (MPa)"
  ),
  caption = "Resistência média por tipo de concreto."
)
```
O resultado apresenta a resistência média de cada tipo de concreto.
A função arrange() organiza os tipos de concreto em ordem crescente, permitindo identificar aquele que apresenta a menor e a maior resistência média na base analisada.
## Questão 26
Para cada tipo de concreto, foram calculadas simultaneamente diferentes estatísticas da variável `resistencia_mpa`, utilizando `group_by()` para separar os grupos e `summarise()` para obter o número de observações, a média, a mediana, o desvio-padrão, o valor mínimo e o valor máximo.
```{r}
estatisticas_resistencia <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    quantidade = n(),
    media = mean(resistencia_mpa),
    mediana = median(resistencia_mpa),
    desvio_padrao = sd(resistencia_mpa),
    minimo = min(resistencia_mpa),
    maximo = max(resistencia_mpa),
    .groups = "drop"
  )

knitr::kable(
  estatisticas_resistencia,
  digits = 2,
  col.names = c(
    "Tipo de concreto",
    "Nº de observações",
    "Média (MPa)",
    "Mediana (MPa)",
    "Desvio-padrão (MPa)",
    "Mínimo (MPa)",
    "Máximo (MPa)"
  ),
  caption = "Estatísticas da resistência à compressão por tipo de concreto."
)
```
A tabela permite uma análise mais completa da resistência à compressão, pois a **média** representa o valor central dos resultados, enquanto a **mediana** permite verificar o comportamento do valor central sem sofrer tanta influência de valores extremos. O **desvio-padrão** informa a variabilidade dos resultados, e os valores **mínimo e máximo** mostram a amplitude das resistências observadas. Além disso, o número de observações indica a quantidade de dados utilizada em cada grupo.
Assim, apresentar várias estatísticas é mais informativo do que utilizar apenas a média, pois permite avaliar simultaneamente **tendência central, dispersão e amplitude dos resultados**, proporcionando uma caracterização mais adequada da resistência de cada tipo de concreto.
## Questão 27
Selecionando somente as variáveis quantitativas relacionadas às propriedades do concreto. A função `select()` permite escolher as variáveis que serão mantidas na tabela.
```{r}
# Selecionando somente as variáveis quantitativas.
# select() seleciona as variáveis que serão mantidas.
# where(is.numeric) seleciona automaticamente as variáveis numéricas.

propriedades_concreto <- dados_limpos |>
  select(where(is.numeric))

# Apresentando a nova tabela.
knitr::kable(
  propriedades_concreto,
  digits = 2,
  caption = "Variáveis quantitativas relacionadas às propriedades do concreto."
)
```
A nova tabela contém somente as variáveis quantitativas relacionadas às propriedades do concreto, excluindo as variáveis de identificação e classificação, como `id_corpo_prova`, `obra` e `tipo_concreto`. Dessa forma, os dados ficam organizados para as próximas análises quantitativas.
## Questão 28
Para calcular simultaneamente a média das variáveis quantitativas da base, foi utilizada a função `across()` em conjunto com `summarise()`. Dessa forma, a mesma operação é aplicada automaticamente a todas as variáveis reconhecidas pelo R como numéricas.
```{r}
# Calculando a média das variáveis quantitativas utilizando across().
# where(is.numeric) seleciona automaticamente as variáveis numéricas.
# mean() calcula a média de cada variável selecionada.

medias_across <- dados_limpos |>
  summarise(
    across(
      where(is.numeric),
      ~mean(.x, na.rm = TRUE)
    )
  )

# Apresentando os resultados.

knitr::kable(
  medias_across,
  digits = 2,
  caption = "Média das variáveis quantitativas utilizando across()."
)
```
Para comparação, as médias também podem ser calculadas individualmente com `summarise()`, sendo necessário indicar cada variável separadamente:
```{r}
medias_individuais <- dados_limpos |>
  summarise(
    idade_dias = mean(idade_dias, na.rm = TRUE),
    resistencia_mpa = mean(resistencia_mpa, na.rm = TRUE),
    cimento_kg_m3 = mean(cimento_kg_m3, na.rm = TRUE),
    relacao_a_c = mean(relacao_a_c, na.rm = TRUE),
    abatimento_mm = mean(abatimento_mm, na.rm = TRUE),
    densidade_kg_m3 = mean(densidade_kg_m3, na.rm = TRUE),
    absorção_agregado_pct = mean(absorção_agregado_pct, na.rm = TRUE),
    resistencia_relativa = mean(resistencia_relativa, na.rm = TRUE)
  )

knitr::kable(
  medias_individuais,
  digits = 2,
  caption = "Média das variáveis quantitativas utilizando summarise()."
)
```
Os dois procedimentos permitem obter as médias das variáveis quantitativas. Entretanto, `across()` torna o código mais prático e reduz a repetição, pois aplica automaticamente a mesma função a todas as variáveis numéricas da base. Dessa forma, caso novas variáveis quantitativas sejam adicionadas, elas também poderão ser incluídas no cálculo sem a necessidade de especificá-las individualmente.
## Questão 29
Para realizar uma transformação simultânea nas variáveis quantitativas, foi utilizada a combinação das funções `mutate()` e `across()`. Nesse caso, foi realizada a **padronização** dos valores, subtraindo a média da variável e dividindo o resultado pelo seu desvio-padrão.
```{r}
# Padronizando simultaneamente as variáveis quantitativas.
# mutate() cria ou modifica variáveis na base de dados.
# across() aplica a mesma transformação a todas as variáveis numéricas.
# A padronização transforma os valores para uma escala comum.

dados_padronizados <- dados_limpos |>
  mutate(
    across(
      where(is.numeric),
      ~(.x - mean(.x, na.rm = TRUE)) / sd(.x, na.rm = TRUE)
    )
  )

# Apresentando os primeiros registros após a transformação.

knitr::kable(
  head(dados_padronizados),
  digits = 2,
  caption = "Variáveis quantitativas após a padronização."
)
```
A padronização transforma as variáveis para uma escala comum, na qual a média passa a ser aproximadamente **0** e o desvio-padrão aproximadamente **1**. Assim, os valores indicam quantos desvios-padrão cada observação está acima ou abaixo da média.
Essa transformação é útil para comparar variáveis que apresentam **unidades e escalas diferentes**, evitando que uma variável com valores numericamente maiores tenha maior influência apenas por sua escala. O uso conjunto de `mutate()` e `across()` torna o procedimento mais prático, pois permite aplicar a mesma transformação simultaneamente a todas as variáveis quantitativas.
## Questão 30
Para comparar as variáveis quantitativas entre os diferentes tipos de concreto, foram calculadas a **média e o desvio-padrão** de cada variável dentro de cada grupo. Para isso, foi utilizada a combinação das funções `group_by()`, `summarise()` e `across()`.
```{r}
# Calculando a média e o desvio-padrão das variáveis quantitativas
# para cada tipo de concreto.
# group_by() separa as observações por tipo de concreto.
# summarise() calcula as estatísticas para cada grupo.
# across() aplica as mesmas funções a todas as variáveis numéricas.

estatisticas_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    across(
      where(is.numeric),
      list(
        media = ~mean(.x, na.rm = TRUE),
        desvio_padrao = ~sd(.x, na.rm = TRUE)
      )
    ),
    .groups = "drop"
  )

# Apresentando os resultados em uma tabela.

knitr::kable(
  estatisticas_tipo,
  digits = 2,
  caption = "Média e desvio-padrão das variáveis quantitativas por tipo de concreto."
)
```
A utilização de `across()` permite aplicar simultaneamente as funções de média e desvio-padrão a todas as variáveis quantitativas, enquanto `group_by()` possibilita realizar os cálculos separadamente para cada tipo de concreto. Dessa forma, é possível comparar tanto os **valores médios** quanto a **variabilidade** das variáveis entre os diferentes grupos.
Essa abordagem torna o código mais compacto e facilita sua manutenção, principalmente quando a base possui um número maior de variáveis quantitativas.
## Questão 31
Para verificar e padronizar os valores da variável `obra`, foram utilizados os dados originais da base, antes da etapa de limpeza. Essa análise permite identificar possíveis diferenças de preenchimento, como espaços adicionais e variações entre letras maiúsculas e minúsculas.
Inicialmente, foram apresentadas as categorias distintas e o comprimento de cada texto. Em seguida, foram aplicadas as funções `str_trim()` e `str_to_upper()` para padronizar os valores.
```{r}
# Verificando os valores originais da variável obra.
# distinct() apresenta as categorias diferentes existentes.
# str_length() permite verificar o comprimento dos textos.

obra_antes <- dados |>
  distinct(obra) |>
  mutate(
    comprimento = str_length(obra)
  )

knitr::kable(
  obra_antes,
  caption = "Valores da variável obra antes da padronização."
)
```
Após a identificação dos valores originais, foi realizada a padronização da variável:
```{r}
# Padronizando os valores da variável obra.
# str_trim() remove espaços no início e no final dos textos.
# str_to_upper() converte todos os caracteres para letras maiúsculas.

dados_padronizados <- dados |>
  mutate(
    obra = obra |>
      str_trim() |>
      str_to_upper()
  )

# Verificando as categorias após a padronização.

obra_depois <- dados_padronizados |>
  distinct(obra) |>
  mutate(
    comprimento = str_length(obra)
  )

knitr::kable(
  obra_depois,
  caption = "Valores da variável obra após a padronização."
)
```
A utilização dos dados originais permite identificar as inconsistências de preenchimento antes que elas sejam alteradas durante a limpeza. As funções `str_trim()` e `str_to_upper()` uniformizam a apresentação dos valores, evitando que diferenças de espaços ou de capitalização façam com que uma mesma categoria seja interpretada como categorias distintas.
Dessa forma, a padronização contribui para melhorar a consistência da variável `obra` e torna sua utilização nas análises posteriores mais adequada.
## Questão 32
Para localizar registros que contenham determinados padrões textuais nas variáveis `tipo_concreto` e `obra`, foi utilizada a função `str_detect()` do pacote `stringr`. A busca foi realizada para identificar ocorrências de `C30` em `tipo_concreto` ou de `Bloco B` em `obra`.
```{r}
# Localizando registros que contenham os padrões textuais especificados.
# str_detect() verifica a presença de determinado padrão no texto.
# regex() permite realizar a busca sem diferenciar letras maiúsculas
# e minúsculas.
# filter() seleciona os registros que atendem a pelo menos uma condição.

registros_padrao <- dados_limpos |>
  filter(
    str_detect(tipo_concreto, regex("C30", ignore_case = TRUE)) |
    str_detect(obra, regex("Bloco B", ignore_case = TRUE))
  ) |>
  select(
    id_corpo_prova,
    obra,
    tipo_concreto
  )

# Apresentando os registros encontrados.

knitr::kable(
  registros_padrao,
  caption = "Registros contendo os padrões textuais pesquisados."
)
```
A função `str_detect()` permite localizar registros a partir de padrões específicos dentro de variáveis textuais. Nesse caso, a utilização de `ignore_case = TRUE` faz com que a busca não seja afetada por diferenças entre letras maiúsculas e minúsculas. Esse recurso facilita a identificação de **categorias específicas e possíveis variações no preenchimento**, contribuindo para o diagnóstico e a padronização da base de dados.
## Questão 33
Para comparar a distribuição da resistência à compressão entre os diferentes tipos de concreto, foi utilizado um gráfico de caixa com a função `geom_boxplot()`.
```{r}
ggplot(
  dados_limpos,
  aes(
    x = tipo_concreto,
    y = resistencia_mpa,
    fill = tipo_concreto
  )
) +
  geom_boxplot(alpha = 0.8) +
  scale_fill_brewer(palette = "Set1") +
  labs(
    title = "Distribuição da resistência à compressão por tipo de concreto",
    x = "Tipo de concreto",
    y = "Resistência à compressão (MPa)",
    fill = "Tipo de concreto"
  ) +
  theme_minimal() +
  theme(
    legend.position = "none",
    plot.title = element_text(face = "bold"),
    axis.title = element_text(face = "bold")
  )
```
O gráfico permite comparar a **mediana, a dispersão e possíveis valores discrepantes** da resistência entre os diferentes tipos de concreto. A linha central representa a mediana, enquanto a caixa representa a distribuição dos valores centrais.
Observa-se que as classes apresentam diferentes distribuições de resistência, sendo esperado que concretos de maior classe apresentem valores mais elevados. A variação no tamanho das caixas também permite comparar a dispersão dos resultados entre as classes.
Dessa forma, o `boxplot` complementa a análise das médias, permitindo avaliar conjuntamente a **tendência central e a variabilidade** da resistência à compressão.
## Questão 34
Para investigar a relação entre o consumo de cimento e a resistência à compressão, foi elaborado um gráfico de dispersão. Como foi identificado um valor de consumo de cimento próximo de `4000 kg/m³`, muito distante dos demais valores, esse registro foi desconsiderado apenas na representação gráfica, pois prejudicava a visualização da relação entre as variáveis.
```{r}
dados_grafico <- dados_limpos %>%
  filter(cimento_kg_m3 < 1000)

ggplot(
  dados_grafico,
  aes(
    x = cimento_kg_m3,
    y = resistencia_mpa
  )
) +
  geom_point(alpha = 0.8) +
  geom_smooth(method = "lm", se = FALSE) +
  labs(
    title = "Relação entre consumo de cimento e resistência à compressão",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
```
Com a retirada do valor discrepante apenas para fins de visualização, o gráfico permite observar melhor a relação entre as duas variáveis. A linha de tendência apresenta a direção geral dos dados, permitindo avaliar se maiores consumos de cimento tendem a estar associados a maiores resistências.
A tendência observada fornece **evidência visual de uma relação positiva**, embora a dispersão dos pontos indique que a resistência não depende exclusivamente do consumo de cimento.
## Questão 35
Para investigar a relação entre a relação água/cimento e a resistência à compressão, foi elaborado um gráfico de dispersão utilizando `ggplot2`, com uma linha de tendência para facilitar a identificação do comportamento dos dados.
```{r}
ggplot(
  dados_limpos,
  aes(
    x = relacao_a_c,
    y = resistencia_mpa
  )
) +
  geom_point(alpha = 0.8) +
  geom_smooth(method = "lm", se = FALSE) +
  labs(
    title = "Relação entre água/cimento e resistência à compressão",
    x = "Relação água/cimento",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
```
O gráfico permite observar a relação entre a quantidade de água em relação ao cimento e a resistência à compressão. A linha de tendência auxilia na identificação da direção geral dos dados.
Observa-se uma **tendência negativa**, indicando que maiores valores da relação água/cimento tendem a estar associados a menores valores de resistência à compressão. Esse comportamento é coerente com o esperado para o concreto, embora a dispersão dos pontos mostre que outros fatores também influenciam a resistência.
A presença de pontos que se afastam do padrão geral merece investigação, pois pode indicar **valores discrepantes, variações nas características dos materiais ou diferenças nas condições de produção e ensaio**.
## Questão 36
Para verificar, em termos descritivos, a afirmação de que os concretos utilizados no Bloco C apresentam desempenho superior aos demais blocos, foram comparadas as medidas de resistência à compressão entre as obras.
Inicialmente, foram calculadas a média, a mediana e o desvio-padrão da resistência para cada obra:
```{r}
resistencia_obras <- dados_limpos %>%
  group_by(obra) %>%
  summarise(
    n = n(),
    média = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) %>%
  arrange(desc(média))

resistencia_obras
```
A distribuição dos resultados foi complementada por meio de um gráfico de caixa:
```{r}
ggplot(
  dados_limpos,
  aes(
    x = obra,
    y = resistencia_mpa,
    fill = obra
  )
) +
  geom_boxplot(alpha = 0.8) +
  labs(
    title = "Distribuição da resistência à compressão por obra",
    x = "Obra",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal() +
  theme(
    legend.position = "none",
    plot.title = element_text(face = "bold"),
    axis.title = element_text(face = "bold")
  )
```
A comparação dos resultados mostra que o **Bloco C não apresenta o maior desempenho em resistência à compressão**. Sua mediana é inferior às observadas nos Blocos B e D, enquanto sua distribuição apresenta também considerável variabilidade.
Portanto, **os dados analisados não dão suporte, em termos descritivos, à afirmação de que os concretos do Bloco C apresentam desempenho superior aos demais blocos**. Essa conclusão se restringe aos resultados observados na base e não envolve teste de hipótese.
## Questão 37
Para analisar a relação entre a idade dos corpos de prova e a resistência à compressão, foram calculadas as médias de resistência para cada idade. O valor de `280 dias` foi desconsiderado por apresentar comportamento discrepante em relação às demais observações.
```{r}
resistencia_idade <- dados_limpos %>%
  filter(idade_dias != 280) %>%
  group_by(idade_dias) %>%
  summarise(
    média_resistencia = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) %>%
  arrange(idade_dias)

resistencia_idade
```
A relação entre idade e resistência média foi representada por meio de um gráfico de linhas:
```{r}
ggplot(
  resistencia_idade,
  aes(
    x = idade_dias,
    y = média_resistencia
  )
) +
  geom_line() +
  geom_point(size = 3) +
  scale_y_continuous(
    limits = c(20, 50),
    breaks = seq(20, 50, by = 5)
  ) +
  labs(
    title = "Resistência média à compressão em função da idade",
    x = "Idade do corpo de prova (dias)",
    y = "Resistência média (MPa)"
  ) +
  theme_minimal() +
  theme(
    plot.title = element_text(face = "bold"),
    axis.title = element_text(face = "bold")
  )
```
Observa-se que a resistência média **não apresenta crescimento contínuo com o aumento da idade**. Há um aumento entre 7 e 14 dias, seguido de redução nas idades posteriores.
Esse comportamento pode ser explicado pelo fato de que a resistência do concreto é influenciada conjuntamente por diversos fatores, como a **relação água/cimento, o consumo de cimento, as características dos materiais e as condições de produção e cura**. Dessa forma, a idade, isoladamente, não explica toda a variação observada.
Assim, os dados indicam um **ganho inicial de resistência**, mas não permitem estabelecer uma relação crescente contínua entre idade e resistência para esta base.
## Questão 38
Para auxiliar o engenheiro no acompanhamento da qualidade do concreto, foi construída uma tabela-resumo com a quantidade de corpos de prova, média, mediana, desvio-padrão, resistência mínima e máxima para cada tipo de concreto.
```{r}
resumo_engenheiro <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    quantidade = n(),
    média = mean(resistencia_mpa),
    mediana = median(resistencia_mpa),
    desvio_padrao = sd(resistencia_mpa),
    mínimo = min(resistencia_mpa),
    máximo = max(resistencia_mpa),
    .groups = "drop"
  )

knitr::kable(
  resumo_engenheiro,
  digits = 2,
  col.names = c(
    "Tipo de concreto",
    "Nº de observações",
    "Média (MPa)",
    "Mediana (MPa)",
    "Desvio-padrão (MPa)",
    "Mínimo (MPa)",
    "Máximo (MPa)"
  ),
  caption = "Resumo estatístico da resistência à compressão por tipo de concreto."
)
```
A **quantidade de observações** indica o número de corpos de prova analisados. A **média e a mediana** permitem avaliar a tendência central da resistência, enquanto o **desvio-padrão** indica sua variabilidade. Os valores **mínimo e máximo** mostram a amplitude dos resultados e podem indicar valores que mereçam investigação.
Essas informações, em conjunto, fornecem uma visão objetiva do comportamento e da uniformidade da resistência dos diferentes tipos de concreto.
## 🏆 Desafio Final
Nesta etapa final, foi desenvolvido um **script integrado em R** para simular a atuação de um engenheiro responsável pelo controle e tratamento de uma base de dados produzida por diferentes profissionais. Como os possíveis erros não são conhecidos previamente, o código foi organizado de forma sequencial, contemplando as etapas de **inspeção, identificação de problemas, limpeza, tratamento e análise dos dados**.
O objetivo é transformar a base inicialmente bruta em uma estrutura mais confiável para a realização de análises estatísticas e para a **tomada de decisão na Engenharia Civil**, utilizando prioritariamente ferramentas da família **tidyverse**.
### Script final
O código abaixo reúne as principais etapas desenvolvidas ao longo da atividade, utilizando funções da família **tidyverse** para organizar, limpar, transformar e analisar os dados de forma sistemática.
```r
# ============================================================
# DESAFIO FINAL — O ENGENHEIRO RESPONSÁVEL PELOS DADOS
# Controle tecnológico do concreto
# ============================================================


# ------------------------------------------------------------
# 1. CARREGAMENTO DOS PACOTES E IMPORTAÇÃO DA BASE
# ------------------------------------------------------------

library(tidyverse)

# Importando a base de dados.
dados <- read_csv2("base_de_dados.csv", trim_ws = FALSE)

# Inspeção inicial da base.
head(dados)
tail(dados)
glimpse(dados)

# Verificando as dimensões da base.
dim(dados)


# ------------------------------------------------------------
# 2. IDENTIFICAÇÃO DE POSSÍVEIS PROBLEMAS
# ------------------------------------------------------------

# Verificando os valores distintos das variáveis qualitativas.
dados |>
  select(id_corpo_prova, obra, tipo_concreto) |>
  map(unique)

# Procurando possíveis caracteres que indiquem erros de
# digitação ou formatação.
dados |>
  filter(
    if_any(
      everything(),
      ~ str_detect(as.character(.x), regex("O|,", ignore_case = TRUE))
    )
  )


# ------------------------------------------------------------
# 3. VERIFICAÇÃO DOS VALORES AUSENTES
# ------------------------------------------------------------

# Contando a quantidade de valores ausentes em cada variável.
dados |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  ) |>
  pivot_longer(
    cols = everything(),
    names_to = "variável",
    values_to = "quantidade_na"
  ) |>
  arrange(desc(quantidade_na))


# ------------------------------------------------------------
# 4. CRIAÇÃO DA BASE PARA LIMPEZA
# ------------------------------------------------------------

# Criando uma cópia para preservar os dados originais.
dados_limpos <- dados


# ------------------------------------------------------------
# 5. PADRONIZAÇÃO DAS VARIÁVEIS QUALITATIVAS
# ------------------------------------------------------------

# Removendo espaços desnecessários e padronizando a escrita.
dados_limpos <- dados_limpos |>
  mutate(
    obra = obra |>
      str_trim() |>
      str_to_upper(),

    tipo_concreto = tipo_concreto |>
      str_trim() |>
      str_to_upper()
  )


# ------------------------------------------------------------
# 6. TRATAMENTO DAS VARIÁVEIS QUANTITATIVAS
# ------------------------------------------------------------

# Corrigindo erros de digitação, separadores decimais e
# convertendo as variáveis para formato numérico.
dados_limpos <- dados_limpos |>
  mutate(
    idade_dias = parse_number(as.character(idade_dias)),

    resistencia_mpa = as.character(resistencia_mpa) |>
      str_replace_all(",", ".") |>
      str_replace_all("O", "0") |>
      parse_number(),

    cimento_kg_m3 = as.character(cimento_kg_m3) |>
      str_replace_all("O", "0") |>
      parse_number(),

    relacao_a_c = as.character(relacao_a_c) |>
      str_replace_all(",", ".") |>
      parse_number(),

    abatimento_mm = parse_number(as.character(abatimento_mm)),

    densidade_kg_m3 = parse_number(as.character(densidade_kg_m3)),

    absorção_agregado_pct =
      parse_number(as.character(absorção_agregado_pct))
  )


# ------------------------------------------------------------
# 7. PADRONIZAÇÃO E TRATAMENTO DOS VALORES AUSENTES
# ------------------------------------------------------------

# Transformando diferentes representações de ausência em NA.
dados_ausentes <- dados_limpos |>
  mutate(
    across(
      everything(),
      ~ na_if(str_trim(as.character(.x)), "")
    )
  ) |>
  mutate(
    across(
      everything(),
      ~ case_when(
        .x %in% c("NA", "N/A", "NULL", "null", "-") ~ NA_character_,
        TRUE ~ .x
      )
    )
  )

# Identificando as observações que possuem valores ausentes.
dados_excluidos <- dados_ausentes |>
  filter(if_any(everything(), is.na))

# Mantendo somente as observações completas.
dados_limpos <- dados_ausentes |>
  filter(if_all(everything(), ~ !is.na(.)))


# ------------------------------------------------------------
# 8. RECONVERSÃO DAS VARIÁVEIS QUANTITATIVAS
# ------------------------------------------------------------

# Garantindo que as variáveis quantitativas estejam em formato
# numérico após o tratamento dos valores ausentes.
dados_limpos <- dados_limpos |>
  mutate(
    idade_dias = parse_number(idade_dias),
    resistencia_mpa = parse_number(resistencia_mpa),
    cimento_kg_m3 = parse_number(cimento_kg_m3),
    relacao_a_c = parse_number(relacao_a_c),
    abatimento_mm = parse_number(abatimento_mm),
    densidade_kg_m3 = parse_number(densidade_kg_m3),
    absorção_agregado_pct = parse_number(absorção_agregado_pct)
  )


# ------------------------------------------------------------
# 9. VERIFICAÇÃO DA BASE APÓS A LIMPEZA
# ------------------------------------------------------------

# Conferindo a estrutura dos dados limpos.
glimpse(dados_limpos)

# Obtendo um resumo das variáveis.
summary(dados_limpos)


# ------------------------------------------------------------
# 10. ESTATÍSTICAS DESCRITIVAS
# ------------------------------------------------------------

# Calculando estatísticas da resistência por tipo de concreto.
resumo_resistencia <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    quantidade = n(),
    média = mean(resistencia_mpa),
    mediana = median(resistencia_mpa),
    desvio_padrao = sd(resistencia_mpa),
    mínimo = min(resistencia_mpa),
    máximo = max(resistencia_mpa),
    .groups = "drop"
  ) |>
  arrange(tipo_concreto)

# Apresentando os resultados em uma tabela.
knitr::kable(
  resumo_resistencia,
  digits = 2,
  caption = "Estatísticas descritivas da resistência à compressão por tipo de concreto."
)


# ------------------------------------------------------------
# 11. CRIAÇÃO DE VARIÁVEIS DERIVADAS
# ------------------------------------------------------------

# Criando uma variável com a resistência de referência de cada
# classe de concreto e calculando a resistência relativa.
dados_limpos <- dados_limpos |>
  mutate(
    resistência_referência = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40,
      TRUE ~ NA_real_
    ),

    resistencia_relativa =
      resistencia_mpa / resistência_referência,

    classificação = case_when(
      resistencia_relativa >= 1.00 ~
        "Igual ou superior à referência",
      resistencia_relativa >= 0.90 ~
        "Próxima da referência",
      TRUE ~
        "Abaixo da referência"
    ),

    acima_media =
      resistencia_mpa > mean(resistencia_mpa)
  )


# ------------------------------------------------------------
# 12. INFORMAÇÕES PARA O ENGENHEIRO
# ------------------------------------------------------------

# Resumo final por tipo de concreto.
resumo_engenheiro <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    quantidade = n(),
    média_resistencia = mean(resistencia_mpa),
    desvio_padrao = sd(resistencia_mpa),
    menor_resistencia = min(resistencia_mpa),
    maior_resistencia = max(resistencia_mpa),
    .groups = "drop"
  ) |>
  arrange(tipo_concreto)

knitr::kable(
  resumo_engenheiro,
  digits = 2,
  caption = "Informações para acompanhamento da qualidade do concreto."
)


# ------------------------------------------------------------
# 13. GRÁFICO 1 — RESISTÊNCIA POR TIPO DE CONCRETO
# ------------------------------------------------------------

ggplot(
  dados_limpos,
  aes(
    x = tipo_concreto,
    y = resistencia_mpa
  )
) +
  geom_boxplot() +
  labs(
    title = "Distribuição da resistência por tipo de concreto",
    x = "Tipo de concreto",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()


# ------------------------------------------------------------
# 14. GRÁFICO 2 — CIMENTO X RESISTÊNCIA
# ------------------------------------------------------------

# O filtro evita que um valor muito elevado de cimento distorça
# a visualização da relação entre as variáveis.
ggplot(
  dados_limpos |>
    filter(cimento_kg_m3 < 1000),
  aes(
    x = cimento_kg_m3,
    y = resistencia_mpa
  )
) +
  geom_point() +
  geom_smooth(
    method = "lm",
    se = FALSE
  ) +
  labs(
    title = "Relação entre consumo de cimento e resistência",
    x = "Cimento (kg/m³)",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()


# ------------------------------------------------------------
# 15. RESULTADO FINAL
# ------------------------------------------------------------

# Visualizando as principais informações geradas para apoiar
# o acompanhamento da qualidade do concreto.
dados_limpos |>
  count(tipo_concreto, classificação) |>
  arrange(tipo_concreto, classificação)
```
O script realiza o processamento dos dados de forma sequencial. Inicialmente, a base é importada e inspecionada para verificar suas **dimensões, estrutura, tipos de variáveis e estatísticas descritivas**. Em seguida, são identificados valores ausentes, erros de preenchimento, categorias despadronizadas e possíveis inconsistências nos dados.
Na etapa de limpeza, a base original é preservada no objeto `dados`, enquanto uma cópia chamada `dados_limpos` é utilizada para as correções. As variáveis qualitativas são padronizadas com `str_trim()` e `str_to_upper()`, enquanto as variáveis quantitativas são corrigidas e convertidas para o formato numérico utilizando funções como `str_replace_all()` e `parse_number()`.
Após o tratamento dos valores ausentes, as observações incompletas são excluídas das análises, resultando em uma base final com dados completos. Essa etapa permite realizar os cálculos estatísticos sem a interferência de valores ausentes.
Também foram criadas variáveis derivadas para ampliar a interpretação dos dados. A variável `resistencia_relativa` compara a resistência observada com a resistência de referência da classe do concreto. A variável `classificacao` permite identificar o desempenho em relação a essa referência. Além disso, `acima_media` indica se a resistência de cada corpo de prova está acima da média de sua respectiva classe.
As funções do **tidyverse**, como `filter()`, `mutate()`, `group_by()`, `summarise()`, `across()`, `case_when()`, `if_any()`, `if_all()`, `str_trim()`, `str_to_upper()`, `str_replace_all()`, `parse_number()` e `ggplot()`, foram utilizadas para organizar, transformar e analisar os dados de forma sistemática.
### Informações geradas para o engenheiro
A partir do script, foram obtidas informações relevantes para o acompanhamento do controle tecnológico, como:
* **número de corpos de prova analisados** após o tratamento;
* **resistência média global**;
* **resistência mínima e máxima**;
* **resistência média por obra**;
* **resistência média por tipo de concreto**;
* **resistência média por idade**;
* **quantidade de corpos de prova por classe**;
* **variabilidade da resistência** por meio do desvio-padrão;
* **resistência relativa à classe do concreto**;
* **classificação dos resultados em relação à referência**;
* **relação entre as propriedades do concreto**, observada por meio dos gráficos.
Essas informações permitem ao engenheiro acompanhar o comportamento da resistência, comparar diferentes tipos de concreto e obras e identificar resultados que possam exigir uma análise mais detalhada.
### Principal problema identificado
O principal problema encontrado na base foi a presença de **inconsistências de preenchimento nas variáveis quantitativas**. Alguns valores que deveriam ser numéricos foram armazenados como texto devido à utilização de vírgulas como separador decimal e à presença da letra `O` no lugar do número `0`.
Um exemplo foi o registro `3O,4`, identificado na variável `resistencia_mpa`, que representa um provável erro de digitação. Também foi identificado o valor `390O` na variável `cimento_kg_m3`.
Além disso, foram encontradas inconsistências nas variáveis qualitativas, como espaços desnecessários em `obra` e diferenças na forma de escrita das classes de concreto, como `C30` e `c30`.
A decisão adotada foi **corrigir os erros de formatação e padronização identificados**, converter as variáveis quantitativas para o formato numérico e excluir as observações que apresentaram valores ausentes após o tratamento. A base original foi preservada no objeto `dados`, permitindo manter os dados originais e realizar as alterações somente na cópia destinada à análise.
# 🧠 Considerações finais
A principal diferença entre utilizar **Base R** e as ferramentas da família **tidyverse** para o processamento de dados está na forma de organizar e executar as operações. O Base R possui funções capazes de realizar as mesmas tarefas, porém o `tidyverse` oferece uma abordagem mais integrada e estruturada, permitindo encadear diferentes operações de forma mais clara e próxima da sequência lógica do processo de análise.
No desenvolvimento desta atividade, funções como `filter()`, `mutate()`, `group_by()`, `summarise()`, `across()` e `case_when()` permitiram realizar etapas de **inspeção, limpeza, transformação e análise** de maneira organizada. Além disso, funções do `stringr` e do `ggplot2` facilitaram, respectivamente, o tratamento das informações textuais e a construção das visualizações.
Assim, embora o **Base R e o tidyverse possam solucionar problemas semelhantes**, o tidyverse apresenta vantagens na organização do código, principalmente quando são necessárias várias etapas de transformação dos dados. Essa característica torna o processamento mais **legível, sistemático e fácil de reproduzir**, o que é importante quando o script precisa ser compreendido e utilizado por outro profissional.
No contexto da Engenharia Civil, essa organização é especialmente relevante, pois os dados utilizados em análises de controle tecnológico podem apresentar erros de digitação, valores ausentes e diferentes formas de preenchimento. Antes de aplicar métodos estatísticos, é necessário garantir que os dados estejam adequadamente estruturados e tratados.
Dessa forma, o principal aprendizado desta atividade foi compreender que a escolha da ferramenta de processamento não está apenas relacionada à obtenção do resultado, mas também à **forma como o processo é estruturado e documentado**. O uso do tidyverse contribui para construir um fluxo de análise mais organizado, facilitando a transformação dos dados brutos em informações confiáveis para auxiliar a tomada de decisão na Engenharia Civil.
# 📖 Referências
::: {#refs}